Où les marques de mode se trompent sur les données produit
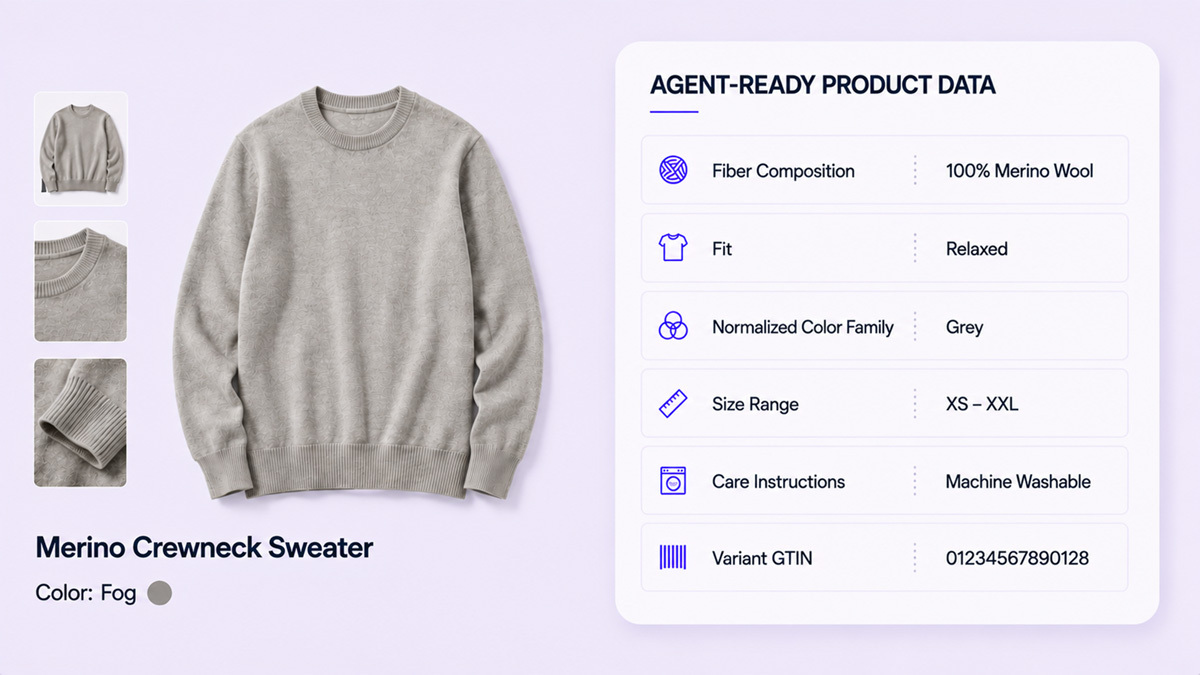
Les marques de mode ne sont pas mauvaises en contenu. Ce sont les meilleures du retail en la matière, et de loin. Les conversations que j’ai avec les équipes merchandising et e-commerce ne commencent presque jamais par un problème de contenu, parce que les photos sont superbes, que les textes ont une voix et que le site convertit. La lacune est ailleurs. Elle se trouve dans les attributs structurés sous-jacents, les valeurs qu’une machine lit quand elle décide quel pull présenter à un acheteur.
Pendant des années, cette distinction a peu compté. Une personne qui parcourt une page catégorie pardonne un champ manquant, parce qu’elle voit le vêtement. Elle regarde la photo, lit deux lignes et se décide.
Un agent ne peut pas faire cela. Quand un acheteur demande à un outil IA un pull col rond en mérinos, lavable en machine, en coupe décontractée, à moins de deux cents euros, l’outil ne regarde pas les photos. Il lit des attributs et il les compare. Un produit dont la composition figure dans un paragraphe, dont la coupe figure dans l’image d’un guide des tailles et dont les instructions d’entretien tiennent dans un symbole sur une étiquette est un produit qui n’entre pas du tout dans la comparaison.
C’est là le tournant, et c’est pour cette raison que les données produit mode méritent qu’on s’y penche sérieusement dès maintenant.
Les attributs sont le produit
Personne n’achète un vêtement parce que sa description est bien écrite. On l’achète parce que c’est la bonne fibre, le bon grammage pour la saison, la bonne coupe aux épaules, dans une couleur qu’on veut vraiment, et qu’il résiste au lavage.
Voilà les attributs : composition en fibres avec les pourcentages, grammage du tissu, construction maille ou tissée, descripteur de coupe, hauteur de taille et entrejambe pour les bas, tour de dessous de poitrine et bonnet pour la lingerie, largeur pour les chaussures, encolure, fermeture, mode d’entretien, pays d’origine, saison, et les certifications de durabilité que la marque a obtenues. Dans la mode, ces valeurs ne sont pas des métadonnées sur le produit. Elles sont le produit, exprimé sous la seule forme qu’une machine sache lire.
La plupart d’entre elles existent quelque part en interne. C’est bien ce qui est frustrant. Le dossier technique connaît la composition. Le guide des tailles connaît les mesures. L’étiquette d’entretien connaît le lavage. Rien de tout cela ne figure dans la fiche produit sous forme de valeur distincte et validée, si bien que rien n’est accessible à un agent, à un filtre ou à une recherche en langage naturel.
Une valeur enfermée dans une phrase est invisible. Une valeur enfermée dans une image n’existe pas.
Un modèle, ce n’est pas un seul produit
Un seul modèle devient des dizaines de fiches dès sa sortie. Six tailles et quatre coloris, cela fait vingt-quatre variantes, et chacune a besoin de son propre identifiant et de son propre jeu de valeurs qui valent réellement pour cette variante.
C’est là que les données mode déraillent sans bruit. La composition appartient au modèle. La couleur appartient au coloris. Les mesures appartiennent à la taille. Quand ces valeurs sont renseignées au mauvais niveau, la fiche se contredit, et la contradiction apparaît au pire endroit possible : la comparaison qu’un acheteur est en train de mener en ce moment même. Une coupe décontractée qui ne l’est que dans trois tailles sur six n’est pas un problème de description. C’est un problème de niveau.
Les identifiants aggravent le problème. Chaque variante vendable a besoin de son propre GTIN, et les places de marché comme les agents identifient les produits à partir de ces identifiants. Un modèle qui partage un seul identifiant entre ses coloris se réduit à un produit unique et ambigu, ou se retrouve en doublon, ou est refusé d’emblée. Bien faire ce travail n’a rien de glorieux et relève de la pure mécanique, et c’est précisément pour cela que ce ne devrait pas être le travail d’une personne. La validation des identifiants devrait atteindre un taux de réussite total avec zéro doublon, à chaque fois, parce qu’un identifiant passe le contrôle ou ne le passe pas. Aucun jugement n’entre en jeu.
Vos noms de couleur ne se filtrent pas
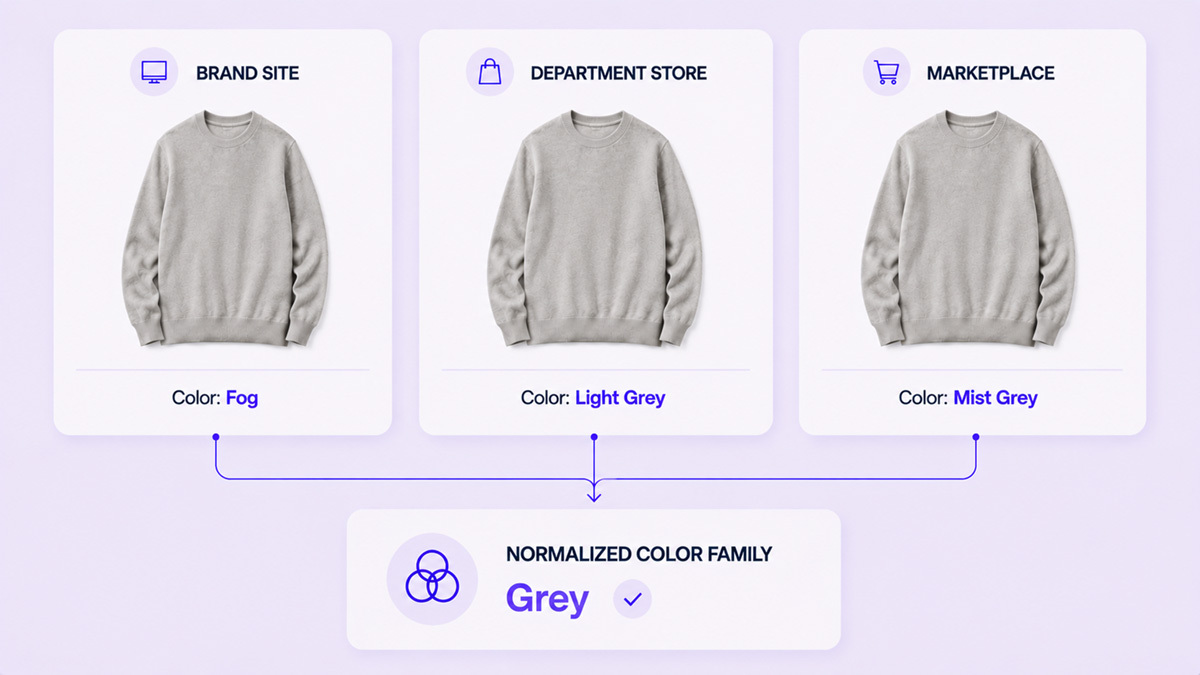
Les noms de couleur d’une marque sont un véritable atout. Fog, Ash, Oatmeal et Bone ont leur place sur la page produit, parce qu’ils portent la marque.
Mais ils ne peuvent être ni filtrés, ni triés, ni comparés. Un acheteur qui restreint sa recherche au gris, comme un agent qui cherche du gris, a besoin d’une famille de couleur normalisée placée derrière le nom choisi par la marque. Pas à sa place. Derrière.
Votre guide des tailles est une image
Les tailles posent le même problème que la couleur, en plus difficile. La mode utilise des tailles en lettres, des tailles numériques, des conversions européennes et britanniques, le denim en tour de taille et entrejambe, et les chaussures dans trois systèmes régionaux, plus la largeur.
Une marque qui gère tout cela sous forme de texte affiché possède un superbe sélecteur de taille, et rien sur quoi une machine puisse raisonner. Les mesures sont affichées plutôt que stockées, si bien que rien en aval ne peut les lire. Ni un filtre, ni une recherche, ni un agent qui compare deux vêtements sur la seule dimension qui décide si l’un d’eux est à la bonne taille.
C’est précisément ce qui coûte de l’argent aux marques de mode sans jamais apparaître dans un rapport. Si les vêtements reviennent, c’est à cause de la coupe, et la coupe est l’attribut qui manque le plus souvent sous forme structurée. Personne ne consigne l’acheteur qui a filtré sur une coupe décontractée et n’a jamais vu le produit, et personne ne consigne le retour qu’une longueur d’entrejambe indiquée aurait évité.
Chaque saison est un nouveau catalogue
Un distributeur industriel peut raisonnablement parler de remettre son catalogue en ordre une fois pour toutes. La mode ne le peut pas. Le catalogue se renouvelle selon un calendrier, plusieurs fois par an, sans compter les lancements de mi-saison et les collaborations qui arrivent encore plus vite.
Le travail n’est donc jamais terminé, et le traiter comme un projet, c’est l’assurance de perdre. Une marque qui a mis ses attributs au point pour le printemps hérite d’un assortiment entièrement nouveau pour l’automne, avec de nouveaux tissus, de nouveaux coloris et de nouvelles coupes, au moment où l’équipe est la plus occupée. La seule approche qui tienne est un pipeline qui s’exécute systématiquement sur chaque nouveau modèle, avec les mêmes règles appliquées à chaque fois.
Ce n’est pas le même achat qu’une opération de nettoyage. C’est aussi la seule chose qui résiste à l’épreuve du calendrier de la mode.
Votre marque est lue à travers les données de quelqu’un d’autre
Voici le point qui retient l’attention en réunion. Une marque ne maîtrise pas la plupart des endroits où ses produits sont décrits.
Les comptes de vente en gros, les grands magasins, les places de marché et les revendeurs ressaisissent tous les informations produit dans leurs propres systèmes, avec leurs propres noms de champs, leurs propres troncatures et leurs propres suppositions sur la nature du tissu. Chacune de ces fiches est une version de la marque. À mesure que les agents IA puisent dans toutes les sources qu’ils peuvent atteindre, la version la plus pauvre et la moins exacte entre en concurrence avec celle de la marque. Parfois, elle l’emporte, parce qu’il se trouve qu’elle est plus lisible par les machines.
Un ensemble unique d’attributs, validé et qui fait autorité, est la réponse à ce problème, et il vaut plus pour une marque premium que pour quiconque, parce que c’est justement la marque premium qui se fait mal décrire par un revendeur discount. Les attributs prêts pour les agents IA sont ce qui permet à une marque de rester reconnaissable sur un canal qu’elle ne possède pas.
À quoi ressemble la bonne approche
La solution n’est pas un système de référence de plus. Les plateformes PIM stockent et organisent ce qu’une marque possède déjà. Elles ne génèrent pas les attributs manquants, et elles ne valident pas les valeurs selon les règles de la catégorie à laquelle appartient le produit.
C’est cette couche de validation qu’il faut automatiser, parce que les règles sont propres à chaque catégorie et qu’il en existe des centaines. Une règle juste pour les vêtements d’extérieur devient un défaut quand on l’applique aux chaussures. atronous maintient un moteur de contraintes couvrant plus de 400 catégories de produits, chacune dotée de son propre vocabulaire de validation, appliqué indépendamment, pour que les attributs mode n’héritent jamais d’une logique écrite pour autre chose. L’IA génère le contenu. La logique déterministe valide chaque valeur avant toute livraison. Rien ne part sans avoir été validé.
Concrètement, cela signifie des attributs structurés générés avec une réelle profondeur, jusqu’à 63 par SKU dans une seule livraison, chaque produit étant d’abord classé dans la bonne catégorie. Une livraison récente pour un grand compte a traité plus de 50 000 fiches produit avec un taux de succès de plus de 98 %, a obtenu un taux de réussite total sur le format et la clé de contrôle des identifiants, avec zéro doublon, et a fait ressortir 18 catégories distinctes d’anomalies de qualité des données, chacune accompagnée de son raisonnement. Les fiches qui ne peuvent pas passer reviennent signalées et expliquées. Rien n’est écarté en silence, et chaque changement de règle est consigné par date, source et justification.
Les mêmes attributs validés remplissent une seconde fonction, que la plupart des marques n’ont pas encore chiffrée. Ils forment la couche sur laquelle reposent la recherche en langage naturel de la marque, ses recommandations et tout agent conversationnel qu’elle exploite. Un acheteur qui demande si un manteau est assez chaud pour un mois de février à Chicago s’interroge sur le pouvoir gonflant, le poids et la doublure. On ne peut répondre à cette question que si ces valeurs existent en tant que valeurs. Tout commence par mesurer ce qui est réellement là, au regard de ce qu’exige la catégorie plutôt que du nombre de champs renseignés.
Voyez ce que voient les agents
Le moyen le plus rapide de savoir où en est un catalogue est d’en faire mesurer un échantillon, qui vous est ensuite renvoyé. Envoyez jusqu’à 50 SKU extraits de votre PIM ou de votre ERP, exactement tels qu’ils vivent dans votre système, et atronous les fait passer par le même pipeline que celui sur lequel s’appuient ses clients grands comptes. Sous cinq jours ouvrés, l’échantillon vous revient généré et validé, avec les recommandations de taxonomie et de schéma qui expliquent le travail, et une session de travail pour passer en revue ce qui a été trouvé.
Sans argumentaire commercial. De vraies fiches, mesurées selon les règles de leurs catégories, pour que les lacunes soient visibles plutôt que théoriques.
Demandez une évaluation de la qualité des données, ou découvrez comment atronous traite les données produit de la mode et de l’habillement.
L’intelligence dans chaque attribut.
Questions fréquentes
Que recouvrent les données produit dans la mode ?
Les données produit mode sont l’ensemble structuré des valeurs qui décrivent un vêtement ou une chaussure avec assez de précision pour qu’une personne ou un système puisse décider s’il convient. Elles couvrent la composition en fibres et ses pourcentages, le grammage et la construction du tissu, le descripteur de coupe, des mesures comme la hauteur de taille et l’entrejambe, l’encolure et la fermeture, une famille de couleur normalisée à côté du nom de couleur choisi par la marque, la gamme complète de tailles dans les systèmes de tailles des marchés où la marque vend, le mode d’entretien, le pays d’origine, la saison, les certifications de durabilité et un identifiant unique pour chaque variante vendable. Dans la mode, la description fait vendre le vêtement, et les attributs décident s’il sera vu un jour.
Pourquoi les agents IA ignorent-ils des produits qui semblent corrects sur le site ?
Parce qu’un agent ne regarde pas la page. Il lit des attributs structurés et les compare d’un produit à l’autre. Quand la composition figure dans un paragraphe, les tailles dans l’image d’un guide des tailles et les instructions d’entretien sur une étiquette, l’agent n’a rien à comparer : le produit est ignoré plutôt que refusé. La fiche paraît saine à la personne qui la relit, mais elle est en pratique absente de la comparaison.
Quelle est la différence entre les attributs de niveau modèle et les attributs de niveau variante ?
Les attributs de niveau modèle valent pour toutes les versions du vêtement, comme la composition en fibres et la construction. Les attributs de niveau coloris valent pour une seule couleur, comme le nom de couleur de la marque et sa famille normalisée. Les attributs de niveau taille valent pour une seule taille, comme les mesures et l’identifiant. C’est en renseignant une valeur au mauvais niveau qu’une fiche finit par se contredire, et la contradiction apparaît dans une recherche filtrée ou dans une comparaison menée par un agent plutôt que sur la page produit : voilà pourquoi elle passe inaperçue.
Cela remplace-t-il un PIM ?
Non. Un PIM est un système de référence. Il stocke et organise ce qu’une marque possède déjà, et cela exige une configuration manuelle. atronous génère les attributs manquants, valide chaque valeur selon les règles de sa catégorie et livre des données vérifiées au PIM, à l’ERP et aux systèmes situés en aval de ceux-ci.