Les agents IA achètent sur la base des attributs. La profondeur et l’exactitude de vos données produit décident de ce qu’ils achètent.
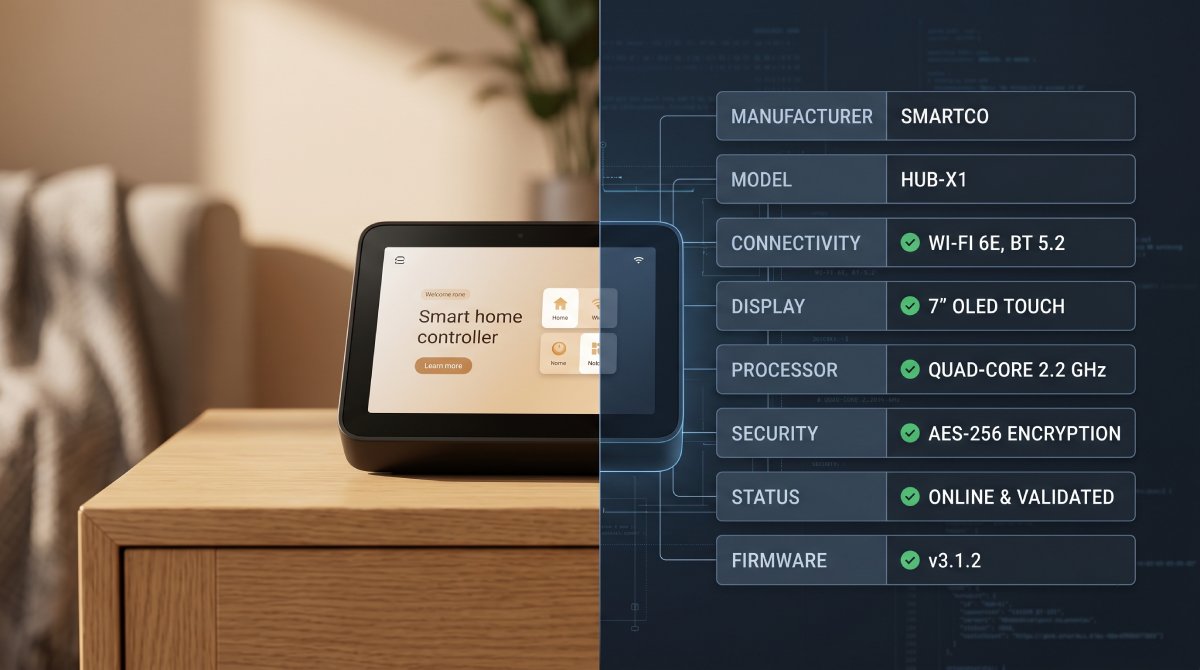
Quand la moitié du web est faite de machines, la valeur se déplace vers la porte et vers la caisse. La décision qui se prend entre les deux repose sur les attributs, et c’est la partie que vous maîtrisez vraiment.
Ce mois-ci, une statistique a franchi un seuil qui devrait changer la façon dont chaque équipe e-commerce envisage ses données produit. Dans Forbes, Renana Ashkenazi, associée chez Grove Ventures, a souligné le moment où les machines sont devenues majoritaires en ligne. Selon le dernier décompte, les visiteurs automatisés représentent désormais 53 % du trafic web. L’essentiel relève du bruit de fond ordinaire du web : scrapers, robots d’indexation et bots de fraude, présents depuis des années. Une part n’a rien d’ordinaire. Le trafic des agents IA a progressé de près de 8 000 % l’an dernier, et c’est cette part qui devrait retenir l’attention de quiconque vend un produit en ligne.
Son article est plus incisif que son titre ne le laisse penser, et il mérite d’être lu en entier. Son propos n’est pas simplement que la publicité est en difficulté. C’est que toute la carte de la valeur sur le web est en train d’être redessinée. Pendant trente ans, le modèle a reposé sur un pari : un humain dans un certain état d’esprit, qui navigue et que la bonne publicité peut capter au bon moment. Un agent IA n’a pas d’état d’esprit. Il consulte une douzaine de détaillants avant que vous n’ayez ouvert le deuxième onglet, ignore la bannière et, comme le dit Ashkenazi, il « lit le prix et les spécifications, achète et s’en va ». Il n’aurait jamais cliqué.
Elle se demande donc où va l’argent une fois que l’emplacement publicitaire cesse de fonctionner, et sa réponse est la partie la plus utile de l’article. La valeur migre vers deux endroits. Elle se déplace vers la porte, où des entreprises comme Cloudflare font désormais payer l’entrée aux robots d’indexation des IA. Et elle se déplace vers la caisse, où Mastercard et Visa ont lancé des couches de paiement conçues pour les transactions minuscules et très fréquentes qu’effectuent les machines. Selon elle, l’emplacement le plus précieux en ligne cesse d’être le panneau publicitaire placé à côté du contenu et devient la barrière de péage placée devant lui.
Elle a raison sur tous ces points. Il y a une couche qu’elle n’aborde pas, et pour quiconque vend réellement un produit, c’est la couche qui décide de qui l’emporte.
Entre la porte et la caisse, l’agent choisit sur la base des attributs
Le péage fait entrer l’agent. L’infrastructure de paiement lui permet de payer. Ni l’un ni l’autre ne décide de ce qu’il achète. Entre les deux se situe le moment qu’Ashkenazi décrit presque en passant, celui où l’agent lit le prix et les spécifications. C’est une décision, et elle se prend sur la base des attributs.
Regardez comment un agent fait réellement ses achats. Une personne tape « téléviseur 65 pouces » et fait défiler ce qui s’affiche. Un agent traite une instruction précise. Trouver un téléviseur OLED de 65 pouces, à moins de 800 €, avec une faible latence d’entrée, livrable cette semaine. Il filtre et classe selon chacun de ces attributs. Chaque attribut de l’instruction est un point de passage obligé. Si la valeur de latence d’entrée manque pour votre produit, vous n’êtes pas moins bien classé. Vous êtes exclu des résultats. L’agent ne peut pas choisir ce qu’il ne peut pas lire.
Une vieille idée se trouve ainsi recadrée pour le nouveau web. Les données produit étaient traitées comme une description, quelque chose à remplir suffisamment bien pour qu’un humain en saisisse l’essentiel. Pour une machine, les données ne sont pas une description. Elles sont la liste d’éligibilité. Le nombre d’attributs validés et décisifs pour l’achat dont vous disposez correspond au nombre maximal de requêtes d’agents dans lesquelles votre produit peut entrer. Des données pauvres ne se contentent pas de mal décrire votre produit. Elles réduisent l’ensemble des décisions de machines dans lesquelles vous avez le droit de concourir. C’est le goulot d’étranglement de la croissance sur le web des agents, et la plupart des entreprises ne le voient pas, parce que leurs données ont été conçues pour un lecteur capable de combler lui-même les lacunes.
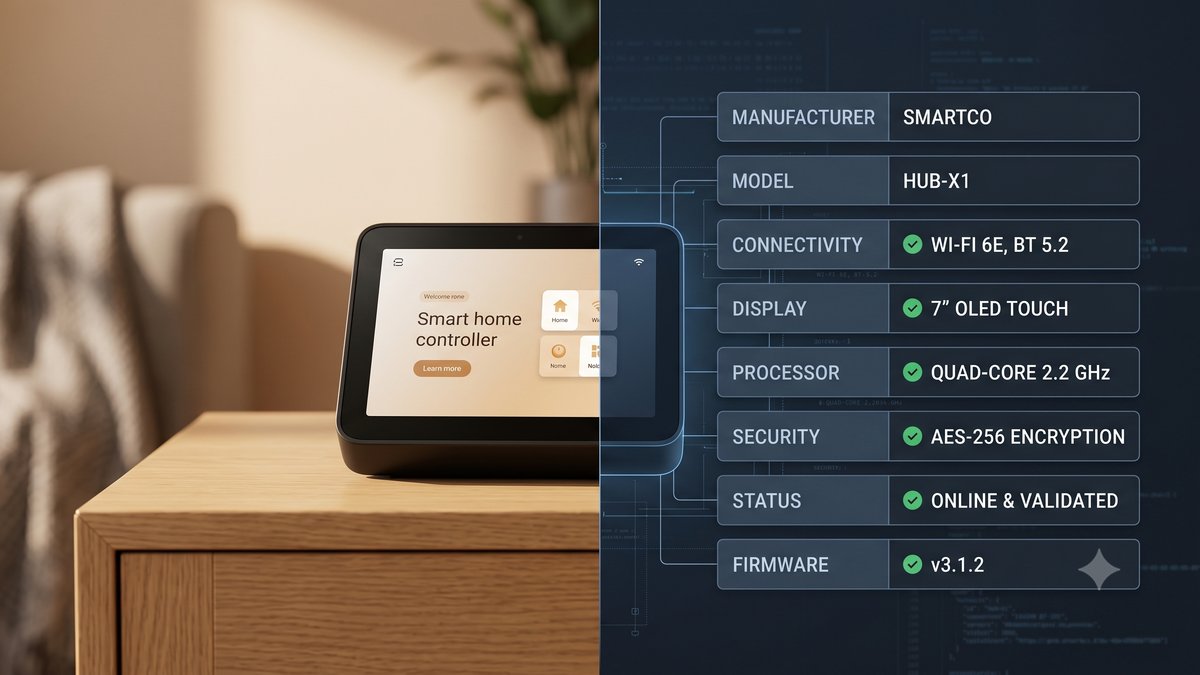
La profondeur n’est que la moitié de l’affaire. L’autre moitié, c’est la preuve.
Davantage d’attributs ne permettent de remporter davantage de requêtes que si ces attributs sont exacts. Un agent ne pardonne pas une valeur erronée comme pourrait le faire une personne. Il calcule sur la mauvaise valeur et passe à autre chose, et une erreur affirmée avec assurance est pire qu’un champ vide, parce qu’elle vous place purement et simplement dans le mauvais ensemble de résultats. L’exigence réelle porte donc sur deux choses à la fois. Les données doivent être assez riches pour entrer dans la comparaison, et assez exactes pour y survivre.
C’est là que la plupart des approches échouent, parce que profondeur et exactitude tirent dans des directions opposées. Générer davantage d’attributs est facile. Générer davantage d’attributs justes, dans le respect des règles de la catégorie concernée, est la partie difficile, et c’est elle qui décide réellement des résultats à la vitesse des machines.
Pourquoi la plupart des données produit ne sont pas prêtes
La plupart des entreprises pensent que leurs problèmes de données produit relèvent du contenu. Descriptions pauvres, titres incohérents, variantes défaillantes. Le vrai problème est structurel, et des machines qui lisent à grande échelle le rendent impossible à ignorer.
Chaque catégorie de produits a ses propres règles. Axes de variation autorisés. Vocabulaires d’attributs. Conventions d’unités de mesure. Logique des identifiants. Une règle correcte pour le mobilier de bureau devient un défaut lorsqu’on l’applique aux instruments d’écriture. Sur des centaines de catégories, la complexité de ces contraintes finit par dépasser ce que les humains et l’IA générique peuvent gérer à la main. Générer des attributs est la partie facile. Générer les bons attributs, dans le respect des bonnes contraintes, pour la bonne catégorie, avec une exactitude que vous pouvez prouver, à grande échelle, voilà la partie non résolue. C’est aussi précisément ce qui décide si un agent IA peut s’appuyer sur vos données pour agir ou s’il passe discrètement son chemin.
Une page qui paraît terminée aux yeux d’une personne peut tout de même échouer face à une machine. La clé de contrôle d’un identifiant est fausse. Un attribut décisif pour l’achat est absent. Une valeur enfreint la règle de catégorie sur laquelle l’agent s’appuie pour comparer. Rien de tout cela n’apparaît sur une capture d’écran. Tout cela est décisif à la vitesse des machines.
Ce que nous faisons pour y répondre
Chez atronous, nous avons construit un moteur d’intelligence des données produit précisément pour ce moment. L’approche repose sur une séparation qui compte davantage à chaque trimestre où la part des machines dans le trafic augmente. L’IA génère le large éventail d’attributs dont un produit a besoin pour être trouvé et comparé. Une logique déterministe valide chaque fiche selon les règles propres à sa catégorie avant toute livraison. Les deux systèmes ne sont jamais confondus, parce que générer des attributs et les prouver sont deux métiers différents.
En dessous se trouve un moteur de contraintes qui couvre plus de 400 catégories de produits, chacune dotée de son propre vocabulaire de validation, appliqué indépendamment. Chaque fiche peut passer plusieurs contrôles de validation avant livraison : format, clé de contrôle, croisement avec les registres, unicité au sein de la livraison et correspondance avec la référence fabricant. Le résultat n’est ni un fichier mince qui se lit sans accroc, ni un fichier épais truffé d’erreurs cachées. Ce sont des données produit riches, vérifiées et prêtes pour la décision, sur lesquelles une machine peut agir sans avoir à deviner.
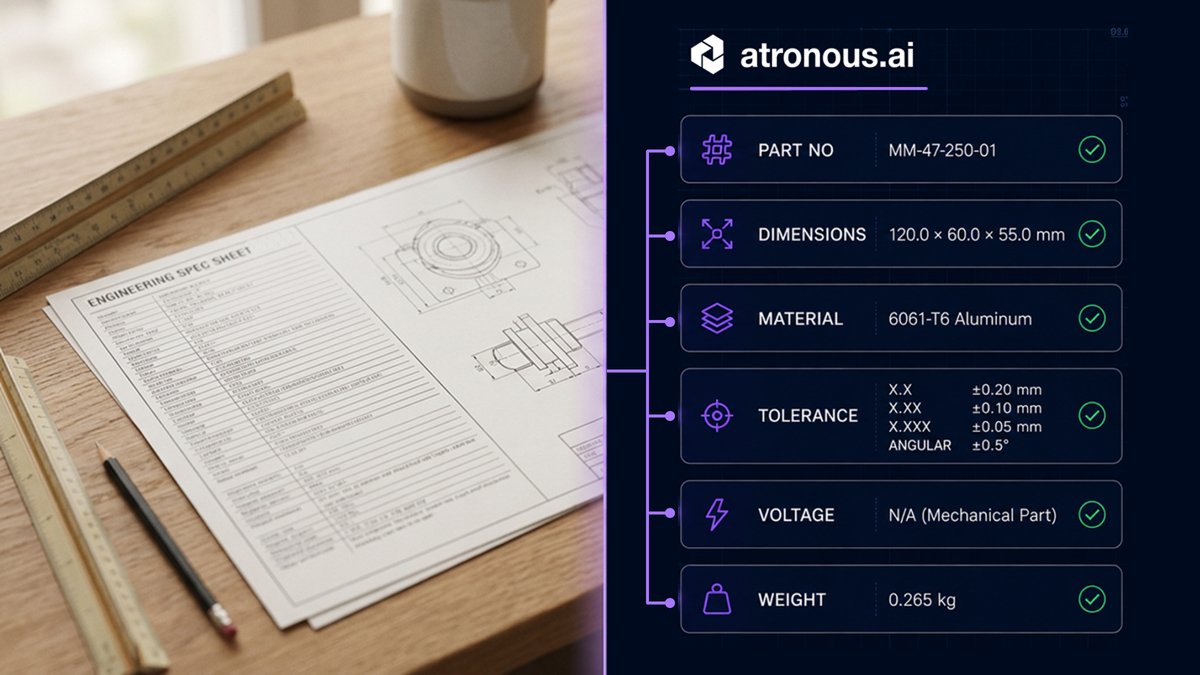
Ici, la profondeur est concrète. Une seule livraison peut contenir 63 attributs produit par SKU, tous validés, ce qui offre une large surface d’éligibilité aux requêtes qu’un agent pourrait lancer. Et le travail s’oriente plus loin encore, vers l’intelligence dérivée : les attributs qu’un produit n’indique pas mais dont un agent a besoin, comme la compatibilité, l’adéquation à un cas d’usage et les caractéristiques qui répondent à la question « avec quoi ce produit fonctionne-t-il ? ». Ce sont des données construites autour du produit, pas seulement à son sujet, et c’est sur ce terrain que se gagne le choix d’une machine.
Les résultats découlent de la méthode. Un fabricant CVC de taille intermédiaire a généré plus de 660 K$ de nouveaux revenus en 90 jours, avec 3x plus de références en ligne sur les places de marché. Une livraison pour un grand compte a traité plus de 50 000 fiches produit avec un taux de succès de plus de 98 %, un taux de validation des identifiants produit de 100 % et zéro doublon d’identifiant. Des tâches qui prenaient des semaines pour quelques centaines de SKU se font désormais en quelques heures pour des milliers, avec jusqu’à 98 % de réduction du temps de traitement. Ces chiffres ont toujours plaidé en faveur de l’efficacité opérationnelle. Sur un web où l’acheteur est de plus en plus une machine, ils font aussi la différence entre être choisi et être ignoré.
À retenir
Ashkenazi a raison de dire que le panneau publicitaire cède la place à la barrière de péage, et raison de dire que les réseaux de paiement prélèveront leur part juste en dessous. Ces deux couches sont construites par d’autres, à la porte et à la caisse. Ce qui reste à tous ceux qui vendent un produit, c’est la partie du milieu, la décision, et cette décision se prend sur la profondeur et l’exactitude de vos attributs.
Le web publicitaire se débat avec ce qu’il perd quand son audience cesse d’être humaine. Le commerce, lui, peut se poser une meilleure question. Quand l’acheteur est une machine qui compare les produits attribut par attribut et décide en quelques millisecondes, votre produit porte-t-il assez de données vérifiées pour être éligible, jugé fiable et choisi ?
L’intelligence dans chaque attribut.