Los agentes de IA compran por atributos. La profundidad y la exactitud de sus datos de producto deciden qué compran.
Cuando la mitad de la web son máquinas, el valor se desplaza hacia la puerta y hacia la caja. La decisión que se toma entre ambas depende de los atributos, y esa es la parte que usted realmente controla.
Este mes, una estadística superó un umbral que debería cambiar la forma en que todo equipo de comercio piensa en sus datos de producto. En un artículo de Forbes, Renana Ashkenazi, socia de Grove Ventures, dejó constancia del momento en que las máquinas pasaron a ser mayoría en internet. Según el último recuento, los visitantes automatizados representan ya el 53 % del tráfico web. La mayor parte es el ruido de fondo habitual de la web: scrapers, rastreadores y bots de fraude que existen desde hace años. Una parte no tiene nada de habitual. El tráfico procedente de agentes de IA creció casi un 8.000 % el año pasado, y esa es la parte que debería captar la atención de cualquiera que venda un producto en línea.
Su artículo es más incisivo de lo que sugiere el titular, y vale la pena leerlo completo. El argumento no es simplemente que la publicidad esté en apuros. Es que se está redibujando todo el mapa de valor de la web. Durante treinta años, el modelo fue una apuesta por un ser humano llevado por su estado de ánimo, que navega y al que el anuncio adecuado puede captar en el momento adecuado. Un agente de IA no tiene estados de ánimo. Consulta una docena de minoristas antes de que usted abra la segunda pestaña, ignora el banner y, como dice Ashkenazi, “lee el precio y las especificaciones, compra y se va”. Nunca iba a hacer clic.
Así que se pregunta adónde va el dinero cuando el espacio publicitario deja de funcionar, y su respuesta es la parte más útil del artículo. El valor migra a dos lugares. Se desplaza hacia la puerta, donde empresas como Cloudflare ahora cobran a los rastreadores de IA por entrar. Y se desplaza hacia la caja, donde Mastercard y Visa han lanzado capas de pago diseñadas para las transacciones diminutas y de alta frecuencia que realizan las máquinas. Según su análisis, el terreno más valioso de internet deja de ser la valla publicitaria junto al contenido y pasa a ser el peaje que está delante de él.
Tiene razón en todo. Hay una capa que no aborda, y para cualquiera que realmente venda un producto, es la capa que decide quién gana.
Entre la puerta y la caja, el agente elige por atributos
El peaje deja entrar al agente. La infraestructura de pago le permite pagar. Ninguna de las dos decide qué compra. Entre ambas está el momento que Ashkenazi describe casi de pasada, el momento en que el agente lee el precio y las especificaciones. Eso es una decisión, y se toma en función de los atributos.
Piense en cómo compra realmente un agente. Una persona escribe “televisor de 65 pulgadas” y recorre lo que aparezca. Un agente trabaja a partir de una instrucción precisa. Encontrar un OLED de 65 pulgadas, por menos de US$800, con baja latencia de entrada y disponible para entrega esta semana. Filtra y ordena según cada uno de esos atributos. Cada atributo de la instrucción es una barrera de acceso. Si a su producto le falta el valor de latencia de entrada, usted no queda más abajo en la clasificación. Queda fuera del conjunto. El agente no puede elegir lo que no puede leer.
Esto replantea una idea antigua para la nueva web. Los datos de producto se trataban como una descripción, algo que había que completar lo bastante bien como para que una persona captara lo esencial. Para una máquina, los datos no son una descripción. Son la lista de elegibilidad. El número de atributos validados y relevantes para la decisión que usted ofrece es el número de consultas de agentes en las que su producto puede llegar a participar. Los datos escasos no solo describen mal su producto. Reducen el conjunto de decisiones de las máquinas en las que se le permite competir. Ese es el cuello de botella del crecimiento en la web de los agentes, y la mayoría de las empresas no lo ve, porque sus datos se crearon para un lector que podía llenar los huecos por sí mismo.
La profundidad es solo la mitad. La otra mitad es la prueba.
Más atributos solo ganan más consultas si los atributos son correctos. Un agente no perdona un valor erróneo como podría hacerlo una persona. Procesa el valor erróneo y sigue adelante, y un error presentado con total seguridad es peor que un campo vacío, porque lo sitúa a usted en un conjunto de resultados completamente equivocado. Así que el verdadero requisito son dos cosas a la vez. Los datos tienen que ser lo bastante profundos para entrar en la comparación y lo bastante correctos para superarla.
Aquí es donde falla la mayoría de los enfoques, porque la profundidad y la exactitud tiran en direcciones opuestas. Generar más atributos es fácil. Generar más atributos correctos, dentro de las reglas de la categoría específica, es la parte difícil, y es la parte que realmente decide los resultados a la velocidad de las máquinas.
Por qué la mayoría de los datos de producto no están listos
La mayoría de las empresas cree que sus problemas de datos de producto son de contenido. Descripciones escuetas, títulos incoherentes, variantes deficientes. El verdadero problema es estructural, y las máquinas que leen a gran escala hacen imposible ignorarlo.
Cada categoría de producto tiene sus propias reglas. Dimensiones de variante permitidas. Vocabularios de atributos. Convenciones de unidades de medida. Lógica de identificadores. Una regla correcta para el mobiliario de oficina se convierte en un defecto cuando se aplica a los instrumentos de escritura. En cientos de categorías, la complejidad de esas restricciones supera lo que las personas y la IA genérica pueden gestionar a mano. Generar atributos es la parte fácil. Generar los atributos correctos, dentro de las restricciones correctas, para la categoría correcta, con una exactitud que se pueda demostrar y a gran escala, es la parte que sigue sin resolverse. Es también exactamente lo que decide si un agente de IA puede actuar a partir de sus datos o los pasa por alto en silencio.
Una página que a una persona le parece terminada puede fallar ante una máquina. El dígito verificador de un identificador es incorrecto. Falta un atributo relevante para la decisión. Un valor infringe la regla de categoría en la que se basa el agente para comparar. Nada de esto se ve en una captura de pantalla. Todo ello es decisivo a la velocidad de las máquinas.
Lo que estamos haciendo al respecto
En atronous creamos un motor de inteligencia de datos de producto precisamente para este momento. El enfoque se basa en una separación que importa más con cada trimestre en que crece la proporción de tráfico que generan las máquinas. La IA genera la amplia gama de atributos que un producto necesita para que lo encuentren y lo comparen. La lógica determinista valida cada registro según las reglas propias de cada categoría antes de entregar nada. Los dos sistemas nunca se mezclan, porque generar atributos y demostrar que son correctos son trabajos distintos.
Debajo de todo ello hay un motor de reglas que abarca más de 400 categorías de producto, cada una con su propio vocabulario de validación, que se aplica de forma independiente. Cada registro puede pasar por varios controles de validación antes de la entrega: formato, dígito verificador, verificación cruzada con el registro emisor, unicidad dentro de la entrega y correlación con la referencia de fabricante. El resultado no es un archivo escaso que se lee sin problemas, ni un archivo abultado lleno de errores ocultos. Son datos de producto profundos, verificados y listos para la decisión, a partir de los cuales una máquina puede actuar sin tener que adivinar.
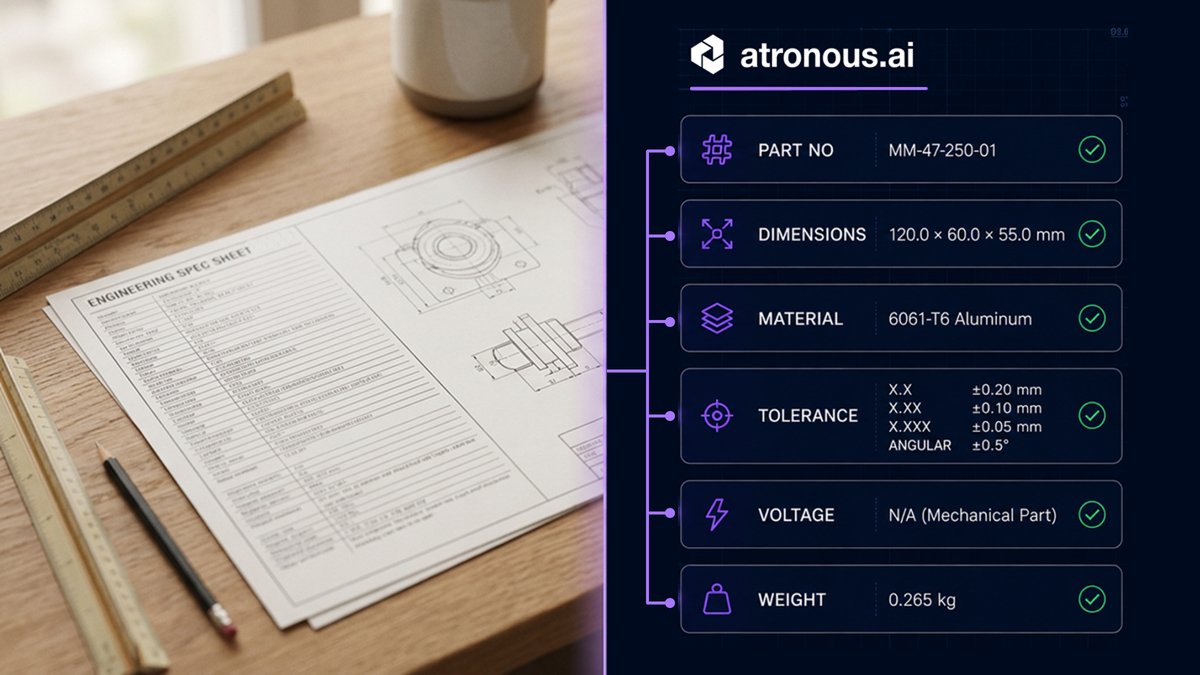
Aquí la profundidad es concreta. Una sola entrega puede incluir 63 atributos de producto por SKU, todos validados, lo que ofrece una amplia superficie de elegibilidad para las consultas que podría hacer un agente. Y la dirección del trabajo va más allá, hacia la inteligencia derivada: los atributos que un producto no especifica pero que un agente necesita, como la compatibilidad, la adecuación al caso de uso y las características que responden a “qué funciona con esto”. Son datos construidos en torno al producto, no solo sobre él, y es ahí donde se consigue que una máquina lo elija.
Los resultados se derivan del método. Un fabricante mediano del sector de climatización (HVAC) generó más de US$660 mil en nuevos ingresos en 90 días y logró 3x más referencias en línea en marketplaces. Una entrega empresarial procesó más de 50 mil registros con una tasa de éxito superior al 98 %, con una tasa de validación de identificadores del 100 % y cero identificadores duplicados. Un trabajo que antes tomaba semanas para unos cientos de SKU ahora toma horas para miles, con hasta un 98 % menos de tiempo de procesamiento. Esas cifras siempre fueron el argumento a favor de la eficiencia operativa. En una web en la que el comprador es cada vez más a menudo una máquina, también marcan la diferencia entre ser elegido y ser pasado por alto.
En resumen
Ashkenazi tiene razón en que la valla publicitaria está cediendo el paso al peaje, y en que las redes de pago se llevarán su parte por debajo de él. Ambas cosas las están construyendo otros, en la puerta y en la caja. Lo que queda para todos los que venden un producto es la parte del medio, la decisión, y esa decisión se toma en función de la profundidad y la exactitud de sus atributos.
La web publicitaria lidia con lo que pierde cuando la audiencia deja de ser humana. El comercio puede plantearse una pregunta mejor. Cuando el comprador es una máquina que compara productos atributo por atributo y decide en milisegundos, ¿tiene su producto suficientes datos verificados para ser elegible, inspirar confianza y ser elegido?
Inteligencia en cada atributo.