Por qué las restricciones de categoría hacen fallar a la IA genérica
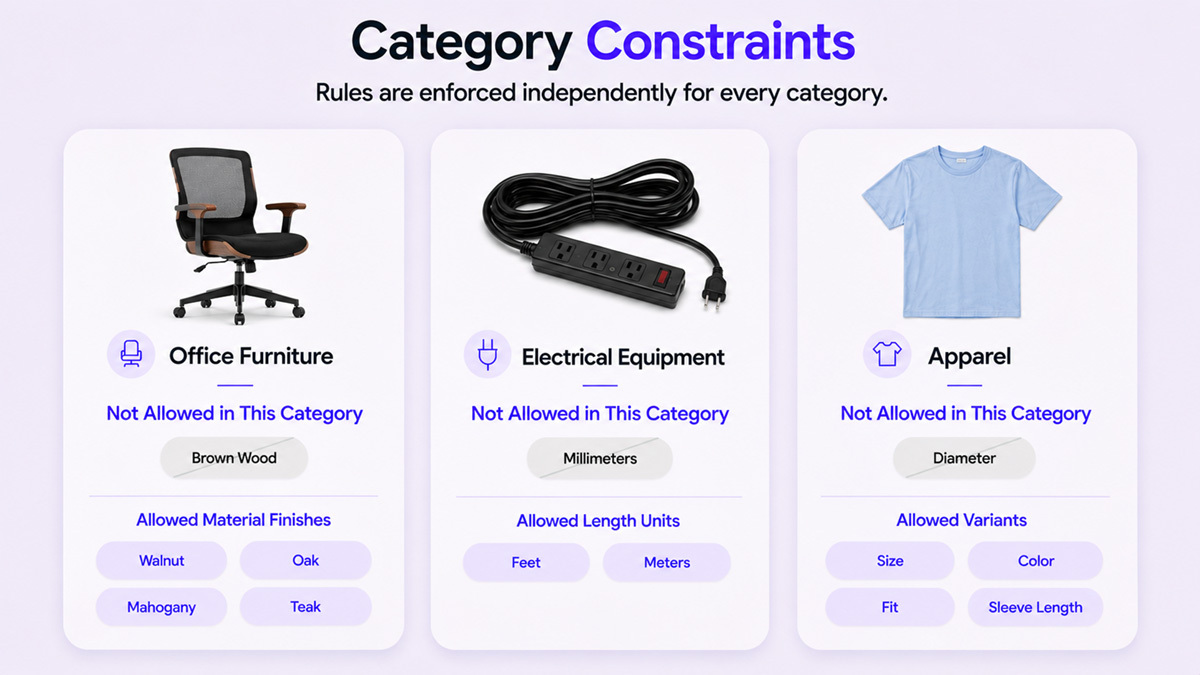
La IA genérica redacta datos de producto fluidos. Fluido y correcto no son lo mismo. Es en la distancia entre ambos donde fallan los catálogos de productos, y se trata de un problema de restricciones, no de contenido.
El fallo que la mayoría de los equipos diagnostica mal
Pídale a un modelo de uso general que complete un registro de producto y lo hará. El resultado se leerá bien. Los atributos tendrán valores, la descripción será clara a simple vista y las unidades parecerán correctas. Luego un marketplace rechaza la ficha o, peor aún, la acepta y los datos quedan en el estante, erróneos sin que nadie lo note.
En ese momento, el instinto es tratarlo como un problema de calidad del contenido. Mejores instrucciones (prompts). Un modelo mejor. Más revisión. Ese instinto es equivocado, y sale caro, porque dirige el esfuerzo hacia la parte del sistema que nunca falló. El modelo no escribe mal. Es ciego a las reglas de la categoría para la que escribe.
Qué es realmente una restricción de categoría
Una restricción de categoría es una regla que es cierta dentro de una rama de una taxonomía y falsa fuera de ella.
Algunas son convenciones de unidades. Una categoría de cables admite la longitud en pies o en metros. Una categoría de elementos de fijación solo admite milímetros. Otras son de vocabulario. Una categoría de muebles puede aceptar “nogal” como valor de material y rechazar “madera marrón”. Otras son estructurales. Una categoría define qué atributos pueden variar dentro de una familia de productos. Una camisa varía por talla y color. Una broca varía por diámetro y tipo de vástago.
El ejemplo de referencia que usamos internamente es la normalización de colores. Una regla que agrupa los tonos en un conjunto controlado de nombres de color es correcta para el mobiliario de oficina. Aplique esa misma regla a los instrumentos de escritura y se convierte en un defecto, porque en esa categoría el tono es el producto.
Ahora multiplique. Un catálogo operativo abarca cientos de categorías. Cada una tiene sus propios requisitos de atributos, sus propios valores permitidos, sus propias convenciones de unidades y su propia lógica de identificadores. Nuestro motor de reglas abarca más de 400 de ellas. Ningún conjunto único de reglas es correcto para todas, y ninguna regla de una categoría puede filtrarse a otra.
Tres formas en que esto hace fallar a la IA genérica
-
Optimiza para lo plausible, no para lo conforme. Un modelo produce el valor más probable según todo lo que ha visto. Los marketplaces no aceptan valores probables. Aceptan valores permitidos. Esos dos conjuntos coinciden con la frecuencia suficiente para ser peligrosos y divergen con la frecuencia suficiente para resultar costosos. Un nombre de material plausible que no figura en el vocabulario de la categoría no pasa de la puerta, y falla en silencio hasta que llega a ella.
-
Las reglas se filtran de una categoría a otra. Un modelo mantiene un único contexto durante toda una ejecución. Los patrones aprendidos de los registros que procesó hace un momento influyen en los registros que procesa a continuación. En casi cualquier otro ámbito, ese comportamiento es útil. En un catálogo multicategoría, es contaminación. La convención de unidades de la última categoría se arrastra a la siguiente. Lo mismo ocurre con el nombre de atributo de la categoría anterior a esa. Nada de ello se señala.
-
No puede decirle cuándo se equivoca. Este es el fallo que más importa. Un modelo generativo devuelve un valor correcto y uno incorrecto con la misma seguridad y la misma fluidez. No hay ninguna señal interna que los distinga. Revisar el resultado tampoco ayuda, porque los errores que sobreviven a la revisión son precisamente los que parecen correctos. Un valor erróneo en una categoría que usted no conoce bien es invisible para todos los que intervienen en la cadena.
Por qué un modelo mejor no lo soluciona
La respuesta natural es recurrir a la escala. Un modelo más grande, una instrucción más larga, una capa de recuperación que contenga las reglas de la categoría. Cada una de estas medidas aporta una mejora marginal. Ninguna cambia la naturaleza del problema.
La razón es el espacio de restricciones. Cientos de categorías, cada una con su propio vocabulario, sus convenciones de unidades, su lógica de variantes y su formato de identificadores, no son un problema de contexto que se resuelva con una ventana más grande. Son un problema de gobernanza. Las reglas tienen que codificarse, versionarse y aplicarse de forma independiente, para que un cambio en una categoría no pueda alterar el comportamiento de otra.
E incluso un modelo que conociera todas las reglas a la perfección seguiría careciendo de lo único que exige el trabajo: un mecanismo para fallar. La generación no conoce el concepto de rechazo. Siempre devuelve algo. Un sistema que siempre devuelve algo no puede ser el sistema que decide qué se entrega.
La arquitectura que sí funciona
La respuesta es la separación, y es una decisión de arquitectura, no de ajuste fino.
La IA genera. La generación es la herramienta adecuada para el enorme espacio de contenido de producto posible, y ningún sistema basado en reglas puede cubrir ese espacio. La lógica determinista valida. La validación es una disciplina distinta, con una condición de éxito distinta, y no debe ejecutarse dentro de la misma pasada que produjo el valor. Esa separación es uno de los requisitos que el enriquecimiento de datos de producto tiene que cumplir para que valga la pena.
La validación, a su vez, funciona en dos niveles. Los controles deterministas resuelven todo lo que una regla puede decidir: formato, dígitos verificadores, unicidad, campos obligatorios, convenciones de unidades y vocabulario de la categoría. Un valor pasa o no pasa, y el resultado es reproducible. Los controles semánticos se ocupan de lo que las reglas no pueden resolver. Leen el registro completo y detectan afirmaciones que, por separado, están bien formadas pero que no concuerdan entre sí. Un material indicado de una forma en el título y de otra en los atributos no es un error de formato. Solo un control que lee el significado lo detecta.
Luego viene la parte que da sentido a todo lo demás: un punto de control bloqueante. Un registro que falla se señala y se documenta con su justificación. No se descarta en silencio ni se deja pasar en silencio. Eso es transparencia de las excepciones, y forma parte de cualquier medida honesta de la calidad de los datos de producto. Elegimos siempre la exactitud antes que la cobertura. Diez mil registros que usted puede respaldar, con las excepciones identificadas, valen más que trece mil con errores ocultos dentro.
Por qué esto sale más caro a medida que los agentes leen el catálogo
Durante mucho tiempo, quien leía un registro de producto era una persona capaz de deducir lo que faltaba. Eso está cambiando. Los agentes de IA no navegan ni deducen con generosidad. Comparan a partir de valores estructurados y actúan según lo que se les da.
Un atributo sin validar solía ser un vacío menor en una página que una persona leía por encima. Ahora es una respuesta errónea que una máquina lee, en la que confía y según la cual actúa. El costo de incumplir una restricción aumenta a medida que el lector se vuelve literal, y el lector se está volviendo literal con rapidez.
Cómo está construido atronous
atronous está construido en torno a esta separación. La IA genera datos de producto en todo el espacio en el que la generación destaca. Una capa de restricciones que codifica las reglas propias de cada categoría en más de 400 categorías de producto valida cada registro, con el vocabulario de cada categoría aplicado de forma independiente. Cada registro pasa varios controles de validación antes de la entrega. Los registros que fallan se devuelven señalados y documentados, con su justificación adjunta. Después, atronous activa los datos verificados en los sistemas que toman el relevo.
Una regla que rige el mobiliario de oficina no puede contaminar los instrumentos de escritura. Eso no es una promesa sobre la calidad del modelo. Es una propiedad de la arquitectura.
Véalo con sus propias categorías
Es fácil defender este argumento en abstracto. Resulta más útil verlo funcionar con sus registros. Envíe hasta 50 SKU desde su PIM o su ERP, tal como están en su sistema. En un plazo de cinco días hábiles, la Evaluación de Calidad de Datos de atronous se los devuelve generados y validados, junto con las recomendaciones de taxonomía y esquema que respaldan el trabajo. Un especialista revisa con usted lo que encontramos y por qué cada categoría se comportó como lo hizo.
Solicite su Evaluación de Calidad de Datos.
Inteligencia en cada atributo.
Preguntas frecuentes
¿Qué es una restricción de categoría?
Una restricción de categoría es una regla que es cierta dentro de una rama de una taxonomía y falsa fuera de ella. Algunas son convenciones de unidades, como una categoría de elementos de fijación que solo admite milímetros. Otras son de vocabulario, como una categoría de muebles que acepta nogal como valor de material y rechaza madera marrón. Otras son estructurales y definen qué atributos pueden variar dentro de una familia de productos. Un catálogo operativo abarca cientos de categorías, y ningún conjunto único de reglas es correcto para todas ellas.
¿Por qué la IA se equivoca con los datos de producto?
Porque optimiza para lo plausible y no para lo conforme. Un modelo generativo devuelve el valor más probable, y los marketplaces aceptan valores permitidos, no valores probables. Además, las reglas se filtran de una categoría a otra dentro de una misma ejecución, de modo que una convención de unidades o un nombre de atributo de una categoría se cuela en la siguiente. Y, lo que es más importante, un modelo devuelve un valor correcto y uno incorrecto con la misma seguridad y la misma fluidez, así que no hay ninguna señal interna que los distinga. La solución no es un modelo mejor. Es una capa de restricciones y una validación determinista que se ejecutan por separado de la generación.