Pourquoi les contraintes de catégorie mettent l’IA générique en échec
L’IA générique rédige des données produit qui sonnent juste. Sonner juste et être exact, ce n’est pas la même chose. C’est dans l’écart entre les deux que les catalogues produit échouent, et c’est un problème de contraintes, pas un problème de contenu.
L’échec que la plupart des équipes diagnostiquent mal
Demandez à un modèle généraliste de remplir une fiche produit, et il le fera. Le résultat se lira bien. Les attributs seront renseignés, la description se parcourra sans accroc et les unités auront l’air justes. Puis une place de marché refuse la fiche, ou pire, l’accepte, et les données se retrouvent en rayon, fausses, sans que rien ne le signale.
Le réflexe, à ce stade, est d’y voir un problème de qualité du contenu. De meilleurs prompts. Un meilleur modèle. Davantage de relecture. Ce réflexe est une erreur, et il coûte cher, car il concentre l’effort sur la partie du système qui n’a jamais été défaillante. Le modèle n’écrit pas mal. Il est aveugle aux règles de la catégorie pour laquelle il écrit.
Ce qu’est vraiment une contrainte de catégorie
Une contrainte de catégorie est une règle qui est vraie dans une branche d’une taxonomie et fausse en dehors.
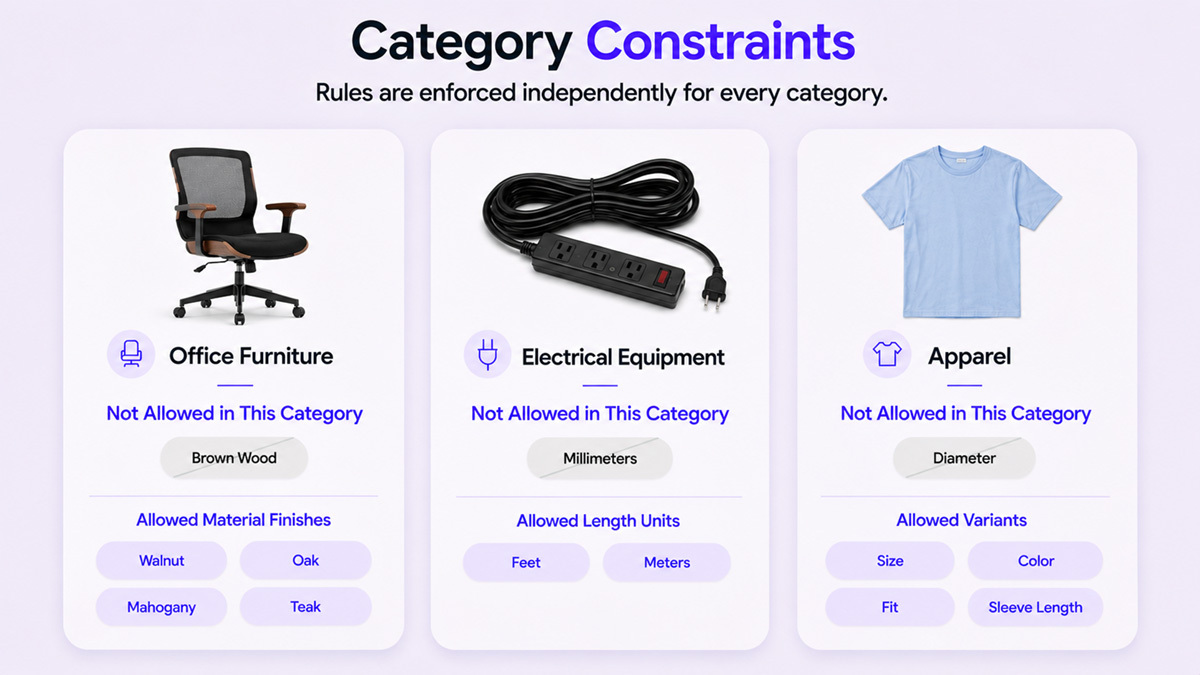
Certaines sont des conventions d’unités. Une catégorie de câbles accepte une longueur en pieds ou en mètres. Une catégorie de fixations n’accepte que les millimètres. D’autres relèvent du vocabulaire. Une catégorie de mobilier peut accepter « noyer » comme valeur de matériau et refuser « bois marron ». D’autres encore sont structurelles. Une catégorie définit les attributs qui peuvent varier au sein d’une famille de produits. Une chemise varie selon la taille et la couleur. Un foret varie selon le diamètre et le type de queue.
L’exemple de référence que nous utilisons en interne est la normalisation des couleurs. Une règle qui ramène les nuances à une liste contrôlée de noms de couleurs est correcte pour le mobilier de bureau. Appliquez la même règle aux instruments d’écriture et elle devient un défaut, car dans cette catégorie, la nuance est le produit.
Et maintenant, multipliez. Un catalogue réel s’étend sur des centaines de catégories. Chacune a ses propres exigences d’attributs, ses propres valeurs autorisées, ses propres conventions d’unités et sa propre logique d’identifiants. Notre moteur de contraintes en couvre plus de 400. Aucun jeu de règles unique n’est correct pour toutes, et aucune règle propre à l’une ne doit déborder sur une autre.
Trois façons dont l’IA générique échoue face à ces contraintes
-
Elle optimise la vraisemblance, pas la conformité. Un modèle produit la valeur la plus probable au regard de tout ce qu’il a vu. Les places de marché n’acceptent pas les valeurs probables. Elles acceptent les valeurs autorisées. Ces deux ensembles se recoupent assez souvent pour être dangereux et divergent assez souvent pour coûter cher. Un nom de matériau plausible qui ne figure pas dans le vocabulaire de la catégorie échoue à l’entrée, et cet échec reste silencieux tant que l’entrée n’est pas atteinte.
-
Les règles débordent d’une catégorie à l’autre. Un modèle conserve un même contexte tout au long d’un traitement. Les motifs appris sur les fiches qu’il vient de traiter orientent celles qu’il traite ensuite. C’est un comportement utile presque partout ailleurs. Dans un catalogue multi-catégories, c’est une contamination. La convention d’unités de la dernière catégorie déteint sur la suite. Le nom d’attribut de la catégorie d’avant aussi. Rien de tout cela n’est signalé.
-
Elle ne peut pas vous dire quand elle se trompe. C’est l’échec qui compte le plus. Un modèle génératif renvoie une valeur correcte et une valeur incorrecte avec la même assurance, et l’une sonne aussi juste que l’autre. Aucun signal interne ne les distingue. Relire le résultat n’aide pas davantage, car les erreurs qui survivent à la relecture sont précisément celles qui ont l’air justes. Une valeur fausse dans une catégorie que vous connaissez mal est invisible pour tous les intervenants de la chaîne.
Pourquoi un meilleur modèle ne règle pas le problème
La réponse naturelle est de miser sur la taille. Un modèle plus grand, un prompt plus long, une couche de récupération contenant les règles de catégorie. Chacune de ces pistes aide à la marge. Aucune ne change la nature du problème.
La raison tient à l’espace des contraintes. Des centaines de catégories, chacune avec son propre vocabulaire, ses conventions d’unités, sa logique de variantes et son format d’identifiant, ce n’est pas un problème de contexte qu’une fenêtre plus large viendrait résoudre. C’est un problème de gouvernance. Les règles doivent être encodées, versionnées et appliquées indépendamment, de sorte qu’un changement dans une catégorie ne puisse pas modifier le comportement d’une autre.
Et même un modèle qui retiendrait parfaitement chaque règle manquerait encore de la seule chose que la tâche exige : un mécanisme lui permettant d’échouer. La génération n’a aucune notion du refus. Elle renvoie toujours quelque chose. Un système qui renvoie toujours quelque chose ne peut pas être celui qui décide de ce qui est livré.
L’architecture qui fonctionne
La réponse est la séparation, et c’est une décision d’architecture plutôt qu’une décision de réglage.
L’IA génère. La génération est le bon outil pour l’immense espace des contenus produit possibles, et aucun système à base de règles ne peut couvrir cet espace. La logique déterministe valide. La validation est une discipline différente, avec un autre critère de réussite, et elle ne doit pas s’exécuter dans la même passe que celle qui a produit la valeur. Cette séparation fait partie des conditions que l’enrichissement des données produit doit remplir pour en valoir la peine.
La validation elle-même opère à deux niveaux. Les contrôles déterministes tranchent tout ce qu’une règle peut décider : format, clés de contrôle, unicité, champs obligatoires, conventions d’unités et vocabulaire de la catégorie. Une valeur passe ou ne passe pas, et le résultat est reproductible. Les contrôles sémantiques traitent ce que les règles ne peuvent pas traiter. Ils lisent la fiche dans son ensemble et repèrent des affirmations qui sont chacune bien formées mais qui ne concordent pas entre elles. Un matériau indiqué d’une façon dans le titre et d’une autre dans les attributs n’est pas une erreur de format. Seul un contrôle attentif au sens le détecte.
Vient ensuite l’élément qui donne tout son poids au reste : un point de contrôle bloquant. Une fiche qui échoue est signalée et documentée, motif à l’appui. Elle n’est ni écartée en silence ni acceptée en silence. C’est la transparence sur les exceptions, et elle a sa place dans toute mesure honnête de la qualité des données produit. L’exactitude avant l’exhaustivité : c’est l’arbitrage que nous faisons à chaque fois. Dix mille fiches dont vous pouvez vous porter garant, avec les exceptions nommées, valent mieux que treize mille fiches dont les erreurs restent enfouies.
Pourquoi cela coûte de plus en plus cher à mesure que les agents lisent le catalogue
Pendant longtemps, le lecteur d’une fiche produit était une personne capable de combler un manque par déduction. Cela change. Les agents IA ne feuillettent pas, et ils n’interprètent pas avec indulgence. Ils comparent à partir de valeurs structurées et agissent sur la base de ce qu’on leur donne.
Un attribut non validé était autrefois une lacune bénigne sur une page qu’un humain parcourait en diagonale. C’est désormais une réponse fausse qu’une machine lit, à laquelle elle se fie et sur laquelle elle agit. Le coût d’une violation de contrainte augmente à mesure que le lecteur devient littéral, et le lecteur le devient rapidement.
Comment atronous est conçu
atronous est construit autour de cette séparation. L’IA génère des données produit sur tout l’espace où la génération est efficace. Une couche de contraintes, qui encode les règles propres à chaque catégorie sur plus de 400 catégories de produits, valide chaque fiche, le vocabulaire de chaque catégorie étant appliqué indépendamment. Chaque fiche passe plusieurs contrôles de validation avant livraison. Les fiches qui échouent sont renvoyées signalées et documentées, motif à l’appui. atronous active ensuite les données vérifiées dans les systèmes qui prennent le relais.
Une règle qui régit le mobilier de bureau ne peut pas contaminer les instruments d’écriture. Ce n’est pas une promesse sur la qualité du modèle. C’est une propriété de l’architecture.
Mettez-le à l’épreuve de vos propres catégories
L’argument est facile à défendre dans l’abstrait. Il est plus utile de le voir à l’œuvre sur vos fiches. Envoyez jusqu’à 50 SKU extraits de votre PIM ou de votre ERP, exactement tels qu’ils vivent dans votre système. Sous cinq jours ouvrés, l’évaluation de la qualité des données d’atronous vous les renvoie générés et validés, avec les recommandations de taxonomie et de schéma qui expliquent le travail. Un spécialiste passe en revue avec vous ce que nous avons trouvé et pourquoi chaque catégorie s’est comportée comme elle l’a fait.
Demandez votre évaluation de la qualité des données.
L’intelligence dans chaque attribut.
Questions fréquentes
Qu’est-ce qu’une contrainte de catégorie ?
Une contrainte de catégorie est une règle qui est vraie dans une branche d’une taxonomie et fausse en dehors. Certaines sont des conventions d’unités, comme une catégorie de fixations qui n’accepte que les millimètres. D’autres relèvent du vocabulaire, comme une catégorie de mobilier qui accepte « noyer » comme valeur de matériau et refuse « bois marron ». D’autres encore sont structurelles : elles définissent les attributs qui peuvent varier au sein d’une famille de produits. Un catalogue réel s’étend sur des centaines de catégories, et aucun jeu de règles unique n’est correct pour toutes.
Pourquoi l’IA se trompe-t-elle sur les données produit ?
Parce qu’elle optimise la vraisemblance plutôt que la conformité. Un modèle génératif renvoie la valeur la plus probable, alors que les places de marché acceptent les valeurs autorisées, pas les valeurs probables. Les règles débordent aussi d’une catégorie à l’autre au cours d’un même traitement, si bien qu’une convention d’unités ou un nom d’attribut propre à une catégorie déteint sur la suivante. Surtout, un modèle renvoie une valeur correcte et une valeur incorrecte avec la même assurance, et l’une sonne aussi juste que l’autre : aucun signal interne ne permet de les distinguer. La solution n’est pas un meilleur modèle. C’est une couche de contraintes et une validation déterministe qui s’exécutent séparément de la génération.