Ce qu’exige vraiment l’enrichissement des données produit
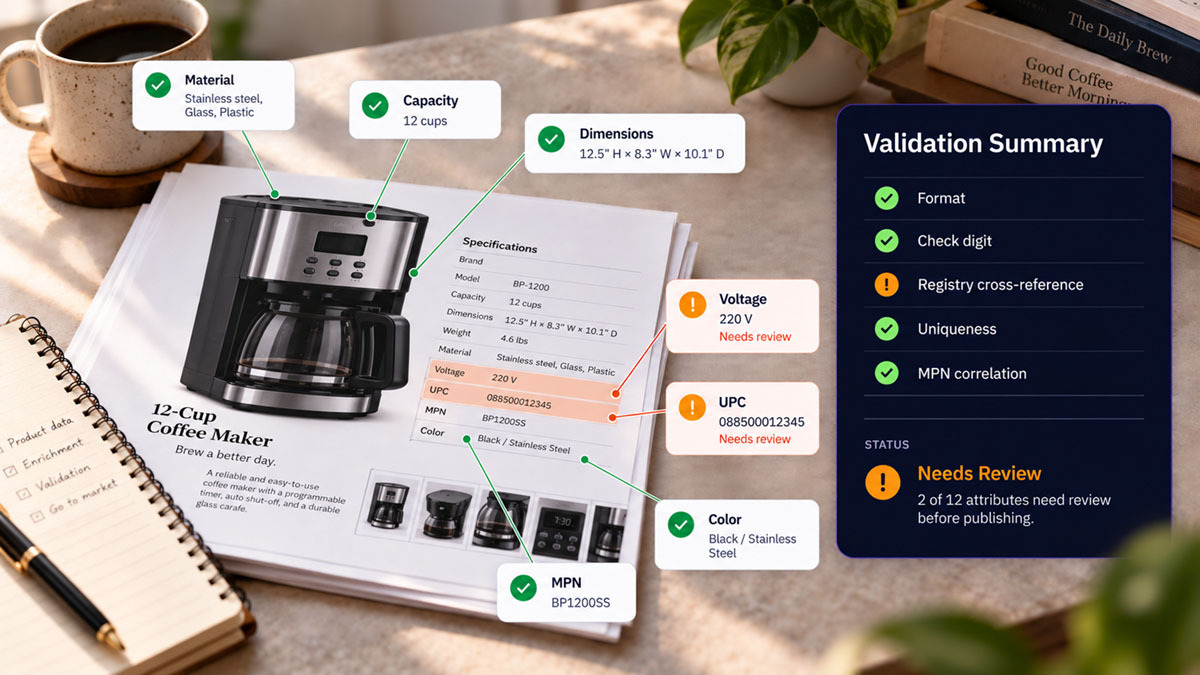
La plupart des équipes traitent l’enrichissement comme un problème de contenu, qui consiste à combler ce qui manque. L’exigence qui décide de sa réussite est celle que la plupart des outils laissent de côté : les données que vous ajoutez doivent être correctes pour la catégorie à laquelle elles sont destinées.
L’enrichissement des données produit consiste à prendre des fiches produit brutes ou incomplètes et à les rendre complètes, structurées et suffisamment exactes pour vendre sur chaque canal qui les lit. C’est la définition sur laquelle la plupart des équipes s’accorderaient. Le désaccord, et la raison pour laquelle tant de chantiers d’enrichissement échouent en silence, porte sur celui de ces trois mots qui pèse le plus. La plupart des outils misent sur « complètes » et « structurées ». Le mot qui décide du résultat, c’est « exactes ».
Ajouter des données, c’est la partie facile. Presque n’importe quel outil moderne sait générer une description, remplir un champ d’attribut vide ou mettre une fiche en correspondance avec un modèle de place de marché. La partie difficile, celle qui sépare les données qui font vendre des données qui se font refuser, consiste à générer la bonne valeur, dans le respect des règles de la bonne catégorie, et à savoir qu’elle est juste avant que la fiche ne soit livrée. Voilà ce qu’exige vraiment l’enrichissement des données produit, et c’est là que la majeure partie du marché s’arrête en chemin.
Ce que la plupart des équipes entendent par enrichissement
Dans l’usage courant, l’enrichissement consiste à combler des manques. Vous partez d’une fiche pauvre (un nom, un prix, peut-être une image) et vous la complétez : une description plus longue, des attributs structurés, des spécifications, de meilleures images, des tags de catégorie et les champs qu’exige chaque place de marché. Les outils de génération de contenu et les plateformes PIM ont rendu ce travail plus rapide d’année en année. Le problème du volume est en grande partie résolu. Vous pouvez produire des milliers de fiches enrichies dans le temps qu’il fallait autrefois pour en terminer quelques centaines.
C’est un travail nécessaire. Les fiches pauvres ne convertissent pas, et les fiches incomplètes ne sont pas acceptées. Mais le volume n’est que la moitié de l’exigence, et c’est la moitié que les outils génériques gèrent déjà bien. Produire plus de données n’est pas la même chose que produire des données correctes. Une fiche peut être complète, bien formatée et fausse en toute assurance.
L’exigence que tout le monde oublie : les données doivent être justes pour leur catégorie
Chaque catégorie de produits a ses propres règles. Axes de variation autorisés, vocabulaires d’attributs, conventions d’unités de mesure, formats d’identifiants : chacun de ces éléments est propre à la catégorie, et une valeur correcte dans une catégorie est un défaut dans une autre. Une règle de normalisation des couleurs écrite pour le mobilier de bureau devient une erreur dès qu’elle est appliquée aux instruments d’écriture. Multipliez cela par des centaines de catégories, chacune avec ses propres contraintes, et la complexité dépasse ce qu’une personne, ou un modèle générique chargé d’enrichir un catalogue, peut embrasser d’un seul regard.
C’est pourquoi un enrichissement qui ajoute des valeurs non validées ne se contente pas de laisser les erreurs en place. Il les démultiplie. Chaque attribut généré sans être contrôlé selon les règles de la catégorie est une occasion de plus d’introduire un défaut que personne ne voit jusqu’à ce qu’une place de marché refuse la fiche, ou pire, jusqu’à ce que la fiche soit en ligne et discrètement fausse. Générer un attribut est simple. Générer le bon attribut, dans le respect des bonnes contraintes, pour la bonne catégorie, avec une exactitude sur laquelle vous pouvez compter à grande échelle, voilà le problème non résolu. C’est la véritable exigence cachée dans le mot enrichissement.
Ce qu’exige vraiment l’enrichissement des données produit
Pour dire les choses simplement, quatre conditions doivent être réunies pour que l’enrichissement en vaille la peine.
-
Une couche de contraintes qui tient compte de la catégorie. Les règles qui régissent chaque catégorie doivent être encodées et appliquées indépendamment, pour qu’une règle valable dans une catégorie ne puisse pas en contaminer une autre. Sans cela, l’enrichissement n’est que de l’approximation, qui a simplement le mérite d’être rapide.
-
Une séparation entre génération et validation. Générer une valeur et confirmer qu’elle est correcte sont deux tâches différentes, et une même passe ne devrait pas faire les deux. La génération parcourt un espace immense de valeurs possibles, et c’est là que l’IA est performante. La validation est une discipline à part, qui opère à deux niveaux. Les contrôles déterministes tranchent tout ce qu’une règle peut décider, comme le format, les clés de contrôle, l’unicité et les champs obligatoires, là où une valeur passe ou ne passe pas. Les contrôles sémantiques prennent en charge ce que les règles ne peuvent pas trancher. Ils lisent la fiche dans son ensemble et repèrent les affirmations contradictoires ou invraisemblables qui, prises une à une, sont bien formées, mais qui ne concordent pas entre elles. Un matériau décrit d’une façon dans le titre et d’une autre dans les attributs n’est pas une erreur de format, et seul un contrôle attentif au sens le repérera. Quand génération et validation se confondent en une seule étape, vous obtenez un résultat plein d’assurance, sans rien pour l’étayer.
-
Des points de contrôle des identifiants et de la complétude, appliqués avant livraison. La validation des clés de contrôle UPC et EAN, la détection des doublons et l’audit des champs obligatoires sont les contrôles déterministes qui repèrent les erreurs les plus coûteuses, et ils doivent s’exécuter avant la livraison d’une fiche, pas après sa mise en ligne. Une fiche qui échoue doit être signalée et documentée, ni écartée en silence, ni laissée passer en silence.
-
L’exactitude avant l’exhaustivité. À choisir, un sous-ensemble validé avec des exceptions clairement signalées a plus de valeur qu’un fichier complet aux erreurs cachées. Livrer dix mille fiches que vous pouvez garantir, avec les manques documentés, est une réussite. En livrer treize mille avec des erreurs enfouies à l’intérieur, c’est le genre d’échec qui ne se révèle qu’une fois devenu coûteux à corriger.
Aucune de ces conditions ne consiste à ajouter davantage. Chacune vise à garantir que ce que vous ajoutez est correct, et que vous le savez avant que cela ne devienne le problème de quelqu’un d’autre en aval.
Pourquoi c’est encore plus important avec l’arrivée des agents IA
Pendant des années, le lecteur d’une fiche produit était un humain, capable de pardonner un manque ou de compenser par déduction une spécification vague. Cela change. À mesure que les agents IA prennent en charge une part croissante de la manière dont les produits sont trouvés, comparés et recommandés, le lecteur est de plus en plus une machine qui ne navigue pas. Elle calcule. Elle compare les produits attribut par attribut, et elle agit sur les données structurées qu’on lui fournit, pas sur la photo qu’une personne aurait examinée en plissant les yeux. Renana Ashkenazi, associée chez Grove Ventures, a situé, dans un article pour Forbes, le moment où les visiteurs automatisés sont devenus majoritaires dans le trafic web. Dans ce contexte, un attribut non validé n’est pas un manque bénin. C’est une réponse fausse qu’un agent lira, à laquelle il se fiera et sur laquelle il agira.
Cela relève la barre de l’enrichissement au lieu de l’abaisser. Le catalogue devient la source qui fait autorité, celle que les agents lisent et à l’aune de laquelle ils comparent, et une source n’est utile que dans la mesure où elle est fiable. Enrichir une fiche avec des données non validées ne la prépare pas à ce monde. Cela la rend seulement plus facile à trouver, et plus susceptible d’être fausse.
À retenir
La bonne façon d’envisager l’enrichissement des données produit n’est pas d’y voir un exercice de contenu, mais un exercice d’exactitude. Ajouter des données, c’est le minimum. Ajouter des données justes pour leur catégorie, validées avant leur livraison et maintenues justes à mesure qu’elles circulent vers chaque canal et chaque agent qui les lit, voilà l’exigence qui compte vraiment. C’est la différence entre un catalogue qui passe à l’échelle et un catalogue dont les erreurs passent à l’échelle.
atronous a été conçu pour répondre à cette exigence. Il génère des données produit sur tout l’espace où l’IA est performante, puis valide chaque fiche selon des règles propres à chaque catégorie qu’aucune passe de génération ne pourrait s’imposer à elle-même. Chaque fiche passe plusieurs contrôles indépendants, déterministes et sémantiques, dans une couche de contraintes qui couvre plus de 400 catégories de produits, avant qu’atronous n’active les données vérifiées dans les systèmes qui prennent le relais.
Commencez par une conversation sur vos données produit.
L’intelligence dans chaque attribut.
Questions fréquentes
Qu’est-ce que l’enrichissement des données produit ?
L’enrichissement des données produit est le processus qui consiste à prendre des fiches produit brutes ou incomplètes et à les rendre complètes, structurées et suffisamment exactes pour vendre sur chaque canal qui les lit. Il couvre la génération des attributs, des descriptions et des spécifications manquants et, s’il est bien mené, la validation de chaque valeur ajoutée selon les règles de la catégorie à laquelle elle appartient.
Qu’exige l’enrichissement des données produit ?
Quatre conditions : une couche de contraintes qui tient compte de la catégorie, pour que les règles d’une catégorie ne puissent pas en contaminer une autre ; une séparation entre génération et validation, pour que l’IA génère les valeurs et que des contrôles indépendants les confirment ; des points de contrôle des identifiants et de la complétude qui s’exécutent avant la livraison, pas après la mise en ligne ; et l’exactitude avant l’exhaustivité, car un sous-ensemble validé avec des exceptions signalées vaut plus qu’un fichier complet aux erreurs cachées.