En qué se equivocan las marcas de moda con los datos de producto
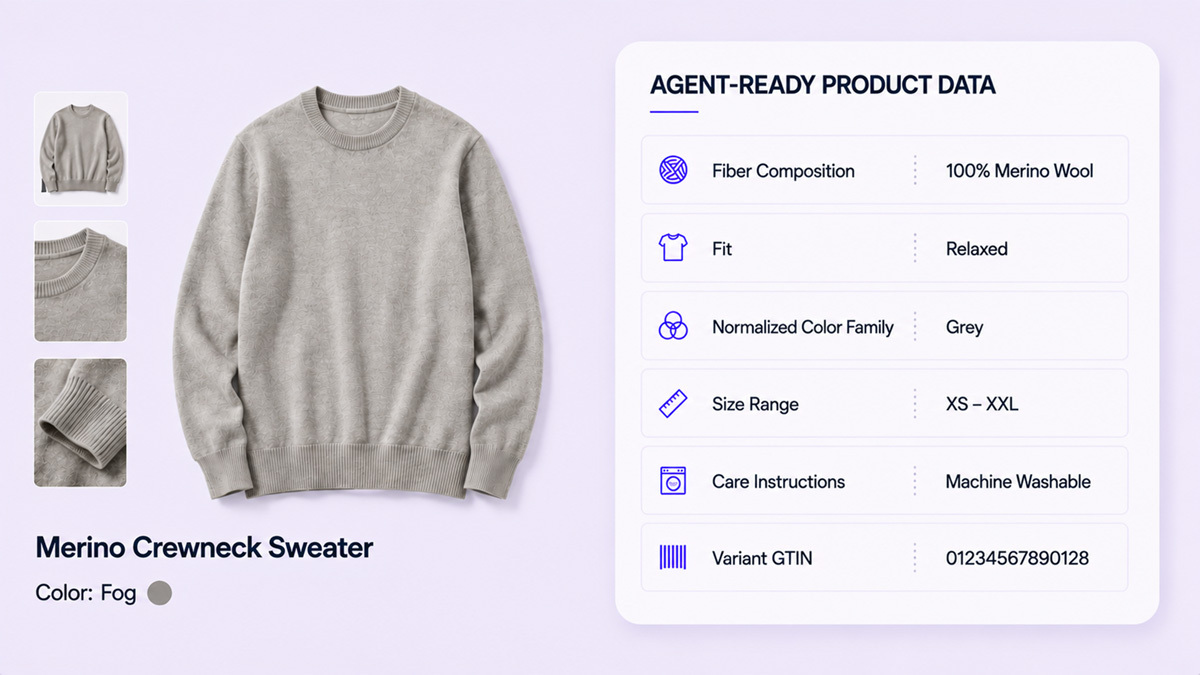
A las marcas de moda no se les da mal el contenido. Son las mejores del retail en eso, y con mucha diferencia. Las conversaciones que tengo con los equipos de merchandising y de e-commerce casi nunca empiezan con un problema de contenido, porque la fotografía es hermosa, los textos tienen voz propia y el sitio web convierte. La brecha está en otra parte. Está en los atributos estructurados que hay debajo, los valores que lee una máquina cuando decide qué suéter mostrarle a un comprador.
Durante años, esa distinción no importó demasiado. Una persona que navega por una página de categoría perdona que falte un campo, porque puede ver la prenda. Mira la foto, lee dos líneas y decide.
Un agente no puede hacer eso. Cuando un comprador le pide a una herramienta de IA un suéter de merino de cuello redondo, lavable a máquina, de corte relajado y por menos de doscientos dólares, la herramienta no mira la fotografía. Lee atributos y los compara. Un producto cuya composición de fibras está en un párrafo, cuyo corte está en la imagen de una tabla de tallas y cuyas instrucciones de cuidado están en un símbolo de una etiqueta es un producto que ni siquiera entra en la comparación.
Ese es el cambio, y es la razón por la que los datos de producto de moda merecen un análisis serio ahora mismo.
Los atributos son el producto
Nadie compra una prenda porque la descripción esté bien escrita. Se compra porque tiene la fibra adecuada, el gramaje adecuado para la temporada, el corte adecuado en los hombros, en un color que de verdad se desea, y porque aguanta un lavado.
Esos son los atributos: composición de fibras con porcentajes, gramaje, construcción de punto o de tejido plano, descriptor de corte, tiro y largo de entrepierna en las prendas inferiores, contorno y copa en la lencería, ancho en el calzado, escote, cierre, método de cuidado, país de origen, temporada y las credenciales de sostenibilidad que la marca se ha ganado. En moda, esos valores no son metadatos sobre el producto. Son el producto, expresado en la única forma que una máquina puede leer.
La mayoría ya existe en algún lugar dentro de la empresa. Eso es lo frustrante. La ficha técnica de producción (tech pack) conoce la composición de fibras. La tabla de tallas conoce las medidas. La etiqueta de cuidado conoce el lavado. Nada de eso está en el registro de producto como un valor independiente y validado, así que nada de eso está disponible para un agente, un filtro o una búsqueda en lenguaje natural.
Un valor atrapado en una frase es invisible. Un valor atrapado en una imagen no existe.
Un estilo no es un solo producto
Un solo estilo se convierte en decenas de registros en cuanto sale a la venta. Seis tallas y cuatro variantes de color son veinticuatro variantes, y cada una necesita su propio identificador y su propio conjunto de valores que sean realmente ciertos para esa variante.
Aquí es donde los datos de moda fallan en silencio. La composición de fibras pertenece al estilo. El color pertenece a la variante de color. Las medidas pertenecen a la talla. Cuando esos valores se asignan en el nivel equivocado, el registro se contradice, y la contradicción aparece en el peor lugar posible: una comparación que un comprador está haciendo en este mismo momento. Un corte relajado que solo es relajado en tres de las seis tallas no es un problema de descripción. Es un problema de nivel.
Los identificadores lo agravan. Cada variante vendible necesita su propio GTIN, y tanto los marketplaces como los agentes identifican los productos a partir de esos identificadores. Un estilo que comparte un mismo identificador entre sus variantes de color se reduce a un único producto ambiguo, o se duplica, o se rechaza directamente. Hacerlo bien no tiene nada de glamuroso y es completamente mecánico, que es justamente la razón por la que no debería ser el trabajo de una persona. La validación de identificadores debería dar siempre una tasa de aprobación total con cero duplicados, porque o se aprueba o no se aprueba. No interviene ningún criterio.
Sus nombres de color no sirven para filtrar
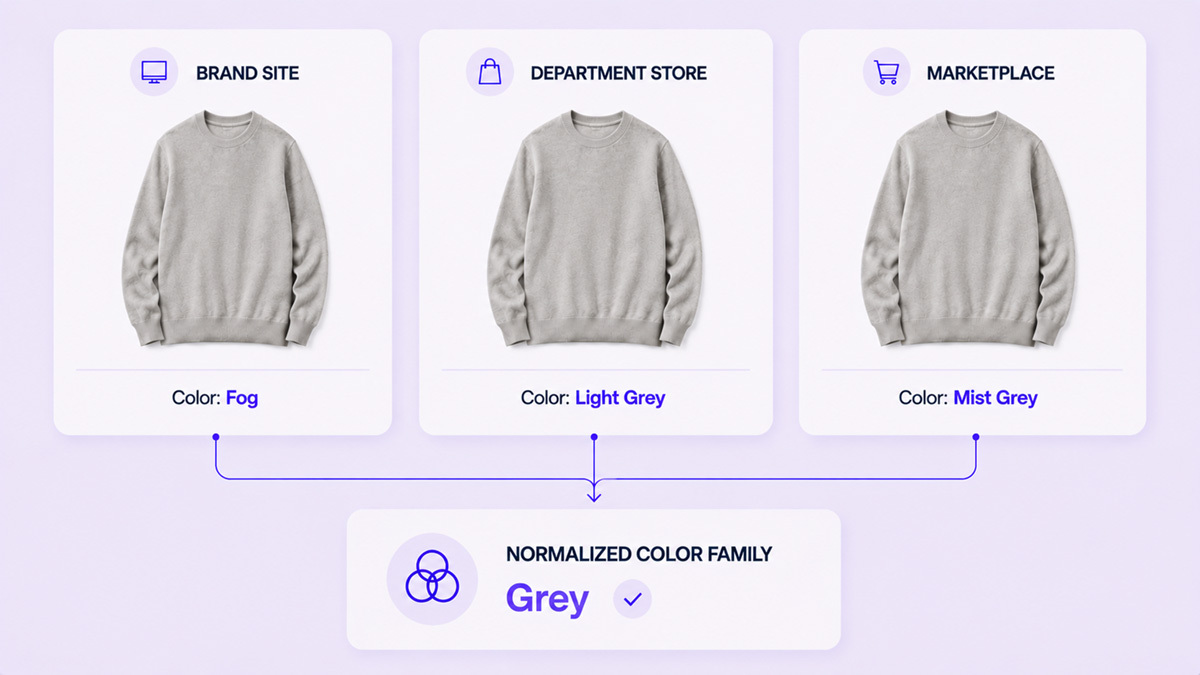
Los nombres de color de la marca son un activo real. Niebla, Ceniza, Avena y Hueso tienen su lugar en la página de producto, porque expresan la marca.
Al mismo tiempo, no se pueden filtrar, ordenar ni comparar. Un comprador que acota la búsqueda al gris, y un agente que busca gris, necesitan una familia de color normalizada detrás del nombre de color de la marca. No en su lugar. Detrás.
Su tabla de tallas es una imagen
Las tallas presentan el mismo patrón que el color, y son más difíciles. La moda usa tallas alfabéticas, tallas numéricas, conversiones a las tallas de la UE y del Reino Unido, el denim en cintura y largo de entrepierna, y el calzado en tres sistemas regionales más el ancho.
Una marca que guarda todo eso como texto para mostrar tiene un selector de tallas muy atractivo y nada con lo que una máquina pueda razonar. Las medidas se muestran en pantalla en lugar de almacenarse, así que ningún sistema posterior puede leerlas. Ni un filtro, ni una búsqueda, ni un agente que compara dos prendas en la única dimensión que decide si una de ellas le queda bien.
Esto es precisamente lo que les cuesta dinero a las marcas de moda sin aparecer nunca en un informe. El corte es la razón por la que se devuelven las prendas, y el corte es el atributo que con más frecuencia falta en forma estructurada. Nadie registra al comprador que filtró por corte relajado y nunca vio el producto, y nadie registra la devolución que un largo de entrepierna indicado habría evitado.
Cada temporada es un catálogo nuevo
Para un distribuidor industrial es razonable hablar de poner en orden el catálogo una sola vez. Para la moda, no. El catálogo se renueva según un calendario, varias veces al año, además de los lanzamientos a mitad de temporada y las colaboraciones, que llegan todavía más rápido.
Así que el trabajo nunca termina, y tratarlo como un proyecto es garantía de perder. Una marca que deja bien sus atributos para la primavera hereda un surtido completamente nuevo para el otoño, con tejidos nuevos, variantes de color nuevas y cortes nuevos, justo cuando el equipo está más ocupado. La única versión de esto que se sostiene es un proceso que se ejecuta sobre cada estilo nuevo de forma rutinaria, con las mismas reglas aplicadas cada vez.
Comprar eso es algo distinto de comprar una limpieza de datos. También es lo único que sobrevive al contacto con el calendario de la moda.
Su marca se está leyendo a partir de los datos de otros
Esta es la parte que capta la atención en la sala. Una marca no controla la mayoría de los lugares donde se describen sus productos.
Los clientes mayoristas, las tiendas por departamentos, los marketplaces y los revendedores vuelven a introducir la información de producto en sus propios sistemas, con sus propios nombres de campo, sus propios recortes de texto y sus propias suposiciones sobre cuál es el tejido. Cada uno de esos registros es una versión de la marca. A medida que los agentes de IA toman datos de cualquier fuente a la que pueden acceder, la versión más escasa y menos exacta compite con la de la propia marca. A veces gana, porque resulta ser más legible por máquina.
Un único conjunto de atributos de referencia, validado, es la respuesta a eso, y vale más para una marca premium que para cualquier otra, porque una marca premium es precisamente la que un revendedor de descuento describe mal. Los atributos listos para agentes de IA son la forma en que una marca sigue siendo reconocible en un canal que no le pertenece.
Cómo es hacerlo bien
La solución no es otro sistema de registro. Las plataformas PIM almacenan y organizan lo que una marca ya tiene. No generan los atributos que faltan ni validan los valores según las reglas de la categoría a la que pertenece el producto.
Esa capa de validación es la que hay que automatizar, porque las reglas son propias de cada categoría y hay cientos de ellas. Una regla correcta para la ropa de abrigo se convierte en un defecto cuando se aplica al calzado. atronous mantiene un motor de reglas que abarca más de 400 categorías de producto, cada una con su propio vocabulario de validación, aplicado de forma independiente, para que los atributos de moda nunca hereden una lógica escrita para otra cosa. La IA genera el contenido. La lógica determinista valida cada valor antes de entregar nada. Nada sale sin haber superado la validación.
En la práctica, eso significa atributos estructurados generados con verdadera profundidad, hasta 63 por SKU en una sola entrega, con cada producto clasificado antes en la categoría correcta. Una entrega empresarial reciente procesó más de 50.000 registros con una tasa de éxito superior al 98 %, obtuvo una tasa de aprobación total en el formato y el dígito verificador de los identificadores con cero duplicados, y detectó 18 categorías distintas de problemas de calidad de datos, con el razonamiento adjunto a cada una. Los registros que no pueden superar la validación vuelven señalados y explicados. Nada se descarta en silencio, y cada cambio de regla queda registrado con su fecha, su fuente y su justificación.
Los mismos atributos validados cumplen una segunda función, la que la mayoría de las marcas todavía no ha cuantificado. Son la capa que sostiene la propia búsqueda en lenguaje natural de una marca, sus recomendaciones y cualquier agente conversacional que gestione. Un comprador que pregunta si un abrigo es lo bastante cálido para un febrero en Chicago está preguntando por el poder de relleno, el peso y el forro. Esa pregunta solo tiene respuesta si esos valores existen como valores. Medir lo que realmente hay, según lo que exige la categoría y no según cuántos campos están completos, es por donde empieza todo esto.
Vea lo que ven los agentes
La forma más rápida de saber en qué punto está un catálogo es que midan una muestra de él y se la devuelvan. Envíe hasta 50 SKU desde el PIM o el ERP, tal como están en el sistema, y atronous los pasa por el mismo proceso en el que confían los clientes empresariales. En un plazo de cinco días hábiles, la muestra se devuelve generada y validada, junto con las recomendaciones de taxonomía y esquema que respaldan el trabajo y una sesión de trabajo para revisar lo que se encontró.
Sin discurso comercial. Registros reales, medidos según las reglas de sus categorías, para que las brechas sean visibles en lugar de teóricas.
Solicite una Evaluación de Calidad de Datos, o vea cómo trata atronous los datos de producto de moda.
Inteligencia en cada atributo.
Preguntas frecuentes
¿Qué son los datos de producto de moda?
Los datos de producto de moda son el conjunto estructurado de valores que describen una prenda o un zapato con la precisión suficiente para que una persona o un sistema decida si es el adecuado. Abarcan la composición de fibras y sus porcentajes, el gramaje y la construcción del tejido, el descriptor de corte, medidas como el tiro y el largo de entrepierna, el escote y el cierre, la familia de color normalizada junto al nombre de color de la marca, el rango completo de tallas en los sistemas de tallas de los mercados en los que vende la marca, el método de cuidado, el país de origen, la temporada, las credenciales de sostenibilidad y un identificador único para cada variante vendible. En moda, la descripción vende la prenda y los atributos deciden si llega a verse alguna vez.
¿Por qué los agentes de IA pasan por alto productos que se ven bien en el sitio web?
Porque un agente no mira la página. Lee atributos estructurados y los compara entre productos. Cuando la composición de fibras está dentro de un párrafo, las tallas están dentro de la imagen de una tabla y las instrucciones de cuidado están en una etiqueta, el agente no tiene nada que comparar, así que el producto se pasa por alto en lugar de rechazarse. La ficha parece correcta para la persona que la revisa y, en la práctica, está ausente de la comparación.
¿Qué diferencia hay entre los atributos a nivel de estilo y los atributos a nivel de variante?
Los atributos a nivel de estilo son válidos para todas las versiones de la prenda, como la composición de fibras y la construcción. Los atributos a nivel de variante de color son válidos para un solo color, como el nombre de color de la marca y su familia normalizada. Los atributos a nivel de talla son válidos para una sola talla, como las medidas y el identificador. Asignar un valor en el nivel equivocado es la forma en que un registro acaba contradiciéndose, y la contradicción aparece en una búsqueda filtrada o en la comparación de un agente y no en la página de producto, razón por la cual pasa inadvertida.
¿Esto sustituye a un PIM?
No. Un PIM es un sistema de registro. Almacena y organiza lo que una marca ya tiene y, para hacerlo, requiere configuración manual. atronous genera los atributos que faltan, valida cada valor según las reglas de su categoría y entrega datos verificados al PIM, al ERP y a los sistemas de destino que se alimentan de ellos.