Ce que la recherche en langage naturel attend de vos données produit
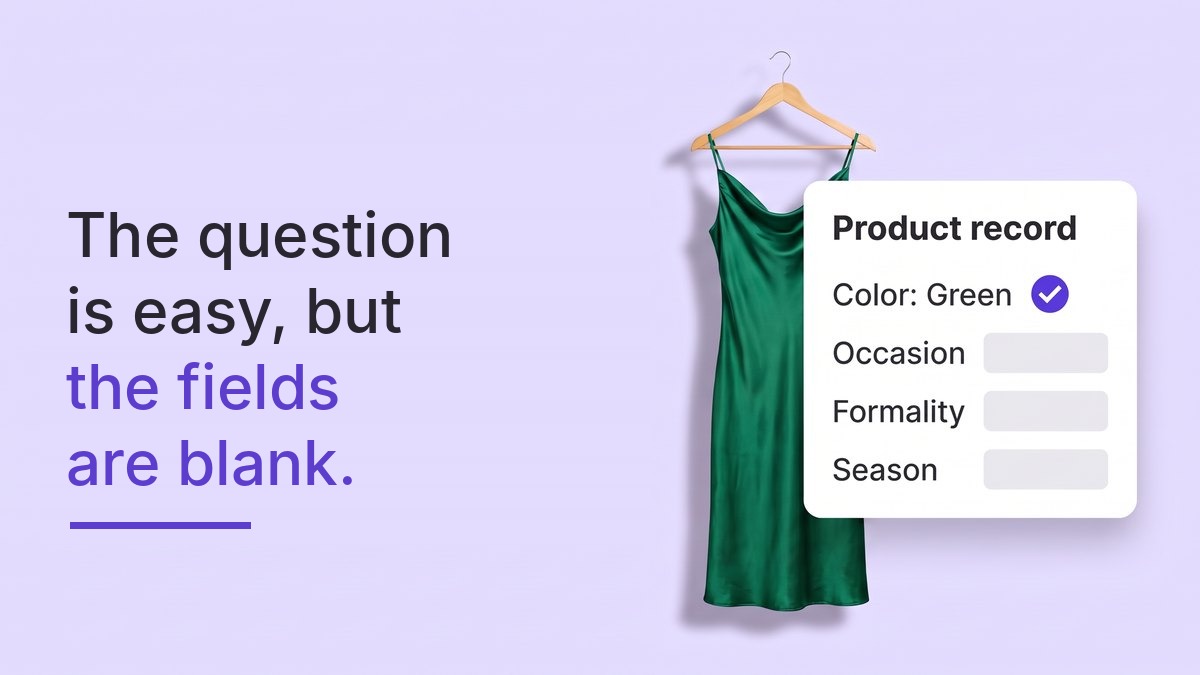
La recherche sur les sites e-commerce est en train de changer. Pendant près de vingt ans, le champ de recherche a rapproché les mots tapés par l’acheteur des mots contenus dans une fiche produit. La nouvelle génération de plateformes de recherche et de découverte sur site est conçue pour faire quelque chose de plus proche de la compréhension. Un acheteur peut taper « une robe sobre pour un mariage en soirée en octobre » ou « une veste de pluie qui se range dans un petit volume pour voyager », et la plateforme cherche à comprendre ce qu’il veut dire, pas seulement les mots qu’il a employés. Plusieurs de ces plateformes ajoutent aussi des interfaces conversationnelles, où l’acheteur affine sa demande en quelques échanges, un peu comme il le ferait avec un vendeur en magasin.
Les démonstrations sont convaincantes, mais elles laissent souvent de côté l’état des données produit dont dépendent les résultats. Une plateforme peut très bien interpréter la demande d’un acheteur et ne trouver presque rien dans les données produit pour y répondre. Lors de l’un de nos échanges avec des clients cet automne, nous avons vu la recherche intégrée d’un site traiter la requête « dress for casual dinner night » (une robe pour un dîner décontracté). Elle n’a renvoyé aucun résultat.
Cet article s’intéresse à cet écart, entre ce que la plateforme peut comprendre et ce à quoi les données produit peuvent répondre. Dans beaucoup de catalogues, c’est le côté données qui s’avère le plus difficile des deux problèmes à résoudre.
La plateforme interprète la question. La fiche produit doit y répondre.
La recherche en langage naturel fonctionne en général en deux temps. D’abord, la plateforme interprète la requête. Elle identifie le type de produit, les qualités qui comptent pour l’acheteur et le contexte de la demande. Ensuite, elle cherche les produits dont la fiche correspond à cette interprétation.
Les modèles de langage ont nettement amélioré la première étape. La seconde dépend toujours de ce que contient chaque fiche produit. Si un acheteur cherche une robe pour un mariage en soirée, la plateforme doit pouvoir savoir quelles robes sont assez habillées, lesquelles conviennent à un événement du soir et lesquelles offrent la couverture que suggère le mot « sobre ». Quand ces qualités sont enregistrées sous forme d’attributs, la correspondance est directe. Quand elles n’apparaissent que sur une photo ou, de façon vague, dans un texte marketing, la plateforme doit les déduire, et le résultat dépend de la qualité de cette déduction pour chaque produit. Quand elles ne sont enregistrées nulle part, le produit ne peut pas être trouvé par cette demande, aussi bien comprise soit-elle.
Certaines plateformes génèrent désormais leurs propres attributs à partir des descriptions et des images, et cela peut aider. Cette approche a aussi des limites qu’il vaut mieux connaître. La plateforme ne peut déduire que ce qui figure dans les textes et les images qu’elle reçoit. Les attributs qu’elle produit ne sont pas toujours vérifiés par l’entreprise. Et ils restent en général dans ce seul outil de recherche, où le flux vers les places de marché, la page de comparaison et l’agent IA qui ont besoin des mêmes réponses ne peuvent pas les utiliser.
C’est l’une des raisons pour lesquelles deux détaillants qui utilisent la même plateforme de recherche peuvent obtenir des résultats très différents. La plateforme est la même. Les données qui l’alimentent ne le sont pas.
Nous sommes déjà passés par là
Ceux qui travaillaient dans l’e-commerce dans les années 2000 reconnaîtront peut-être le schéma. Quand la navigation à facettes, ou navigation guidée, est arrivée, avec des plateformes comme Endeca, elle promettait aux acheteurs de pouvoir affiner un large assortiment selon les qualités qui comptaient pour eux : taille, couleur, matière, coupe, prix. La technologie fonctionnait. Ce que beaucoup de détaillants ont découvert pendant la mise en œuvre, c’est que leurs données produit ne suivaient pas. Les attributs étaient manquants, incohérents ou saisis en texte libre. Les filtres ont été lancés avec une poignée de valeurs, et une longue traîne de produits n’apparaissait sous aucun d’eux. Pour beaucoup d’organisations, le projet de navigation est devenu un projet d’attributs, et le travail sur les attributs a pris bien plus de temps que le logiciel.
La recherche en langage naturel marque un tournant comparable, avec une différence importante. Un filtre s’appuie sur une liste définie d’attributs et de valeurs. Quelqu’un décide à l’avance que les robes auront un filtre d’encolure et qu’il proposera cinq options. Une requête en langage naturel n’a pas de telles limites. Un acheteur peut poser une question sur l’occasion, la saison, le toucher d’un tissu, ce avec quoi un produit s’associe, ou encore la compatibilité d’une pièce avec un appareil qu’il possède déjà. L’ensemble des attributs potentiellement utiles est plus large, plus difficile à prévoir et plus dépendant du contexte que tout ce qu’exigeait une navigation à facettes.
À quoi ressemblent « suffisamment de données »
Il peut être utile de penser par couches les données dont la recherche en langage naturel a besoin.
La première couche regroupe les attributs de base que la plupart des catalogues s’efforcent déjà de tenir à jour : type de produit, taille, couleur, matière, dimensions et marque. Ils sont nécessaires, mais à eux seuls ils répondent rarement à une requête conversationnelle.
La deuxième couche réunit les attributs descriptifs qui traduisent l’usage d’un produit et la façon dont on le juge : occasion, niveau de formalité, silhouette, saison, coupe, entretien et usage prévu. Ce sont ces attributs qui permettent à une plateforme de rapprocher « quelque chose pour un mariage en soirée » des bons produits. Ce sont aussi ceux que les équipes merchandising prévoient le plus souvent d’ajouter et ont rarement le temps de traiter. Nous avons expliqué ailleurs pourquoi un tag et un attribut ne sont pas la même chose, et cela compte ici, car une plateforme de recherche peut comparer des attributs d’une façon qu’elle ne peut pas appliquer à des tags épars.
La troisième couche est le vocabulaire des acheteurs. Les acheteurs et les marques décrivent souvent le même produit différemment. Une marque peut parler de savon pour le visage, alors que ses clients disent systématiquement nettoyant. Les plateformes de recherche gèrent une partie de cela avec des listes de synonymes, mais une fiche qui reflète déjà la façon dont les clients décrivent un produit donne plus de matière à la plateforme.
Un quatrième élément traverse les trois couches : les relations entre produits. Ensembles et coordonnés, articles qui complètent une tenue, pièces et accessoires compatibles, nouvelles versions d’articles arrêtés : tout cela aide une plateforme à répondre à des demandes qui portent en réalité sur plus d’un produit.
Le même raisonnement s’applique aux catalogues industriels et de distribution, avec un autre vocabulaire. Un acheteur qui cherche « vanne à boisseau sphérique en laiton 1/2 pouce, 600 psi » pose une question en langage naturel presque entièrement composée de spécifications. La plateforme peut l’analyser. Qu’elle renvoie la bonne vanne dépend de la façon dont les pressions nominales, les diamètres de raccordement et les matières sont enregistrés : en valeurs structurées dans une convention d’unités cohérente, ou dispersés entre les titres et les fiches techniques, dans plusieurs conventions.
Le second problème : les données existent, mais pas là où la recherche peut les utiliser
Si les attributs manquants n’existaient tout simplement pas, il suffirait de les créer. En pratique, une grande partie de l’information existe déjà quelque part dans l’entreprise. Elle n’est simplement pas dans la fiche produit qui alimente la recherche.
Les détails de fabrication d’un produit peuvent se trouver dans un système de gestion du cycle de vie produit (PLM) ou dans une fiche technique de développement. Son encolure, son motif et sa silhouette sont visibles sur ses photos, mais aucun champ ne les enregistre. Sa façon de tailler, et les mots que les clients emploient pour le décrire, figurent dans les avis. Dans les catégories industrielles, les spécifications se trouvent souvent dans des documents fabricant qui n’ont jamais été entièrement saisis. Plusieurs responsables e-commerce avec qui nous avons échangé cet automne ont décrit des équipes qui ressaisissent les attributs d’un système à l’autre à chaque nouvelle collection.
C’est ce qui rend la collecte difficile. L’information est répartie entre des systèmes aux propriétaires, aux formats et aux cycles de mise à jour différents, et une grande partie n’est pas structurée. Beaucoup des fonctions d’IA désormais disponibles dans les outils de commerce travaillent à partir des données déjà chargées. Elles peuvent réécrire une description ou remplir un champ à partir d’un texte déjà présent, ce qui est utile. Elles ne sont pas conçues pour examiner une photo, une fiche technique ou un ensemble d’avis et en tirer un attribut qui n’est jamais entré dans le système.
Faire entrer les données, c’est la moitié du travail. Les rendre justes, c’est l’autre moitié.
Collecter des attributs à partir de contenus non structurés soulève une question légitime, revenue à plusieurs reprises dans nos échanges : qui vérifie le résultat ?
La question compte davantage pour la recherche que pour la plupart des autres usages des données produit, car une plateforme de recherche prend les attributs pour argent comptant. Si un attribut manque, le produit n’est pas trouvé pour cette demande. Si un attribut est faux, le produit est trouvé pour la mauvaise demande et présenté à un acheteur à qui il ne convient pas. Dans le premier cas, on perd une vente. Dans le second, on perd une vente et une part de la confiance de l’acheteur dans le champ de recherche.
Les attributs qui alimentent la recherche doivent donc être vérifiés avant d’y arriver. Les valeurs doivent provenir d’un vocabulaire contrôlé propre à la catégorie plutôt que de texte libre. Les unités doivent être cohérentes, pour que chaque pression nominale ou chaque grammage de tissu d’une catégorie puisse être comparé à tous les autres. Chaque valeur générée doit porter la trace de son origine et du niveau de confiance du système, afin que les équipes examinent les exceptions plutôt que chaque fiche. Chez atronous, nous séparons volontairement ces tâches : l’IA génère les valeurs d’attributs, et des règles déterministes, propres à chaque catégorie, les valident avant leur livraison.
La place d’atronous
Atronous construit la fiche produit que ces plateformes lisent. Il réunit l’information issue des sources décrites plus haut, notamment les systèmes produit, les fiches techniques, les images et les avis clients, et génère les attributs dont une catégorie a besoin, y compris des attributs qu’une équipe n’a pas encore définis dans son propre schéma. Chaque valeur est validée selon les règles de sa catégorie avant livraison. Le résultat va vers les systèmes que l’entreprise utilise déjà, comme son PIM et sa plateforme e-commerce, et de là vers la recherche sur site, les places de marché et les flux que lisent les agents IA.
La recherche est une application de ce travail. Pour les détaillants aux assortiments étendus, c’est souvent celle dont le lien avec le chiffre d’affaires est le plus net, car les acheteurs qui utilisent la recherche sont en général proches de l’achat. Ce n’est pas la seule. La même fiche validée sert les annonces sur les places de marché, la comparaison de produits et les agents IA qui commencent à recommander des produits pour le compte des acheteurs. Nous avons écrit sur la façon dont les agents IA décident à partir des attributs et sur ce qu’exige vraiment l’enrichissement des données produit. Construire la base une seule fois, plutôt que d’enrichir les données séparément pour chaque canal et chaque outil, permet à l’investissement de profiter à tous.
Là où cela compte le plus, et là où cela compte moins
Il vaut la peine de préciser où cela s’applique. Dans nos échanges, les détaillants les plus préoccupés par la recherche avaient des assortiments étendus. Leurs acheteurs explorent davantage l’offre et ont tendance à décrire ce dont ils ont besoin plutôt qu’à nommer un produit : une robe pour une occasion, des chaussures pour une activité, un bijou pour un style ou un cadeau. Les catalogues plus restreints, portés par une marque, sont souvent recherchés par nom de produit, et l’un des responsables avec qui nous avons échangé plaçait la recherche sur site loin dans sa liste de priorités, précisément pour cette raison. Pour ces entreprises, le même travail sur les données rapporte en général davantage par le référencement naturel et la visibilité dans les assistants IA que par le champ de recherche du site.
Les catalogues industriels et de distribution se situent entre les deux. Beaucoup d’acheteurs cherchent par référence, ce que la recherche par mots-clés gère déjà bien. L’opportunité se trouve dans les recherches qui décrivent un besoin plutôt qu’une pièce, et c’est là que des spécifications normalisées déterminent ce qui est trouvé.
Les questions à se poser avant d’évaluer une plateforme de recherche en langage naturel
Quelques questions permettent de mesurer le degré de préparation d’un catalogue avant de lancer une évaluation.
Quelles recherches ne renvoient rien aujourd’hui, ou renvoient les mauvais produits ? La plupart des plateformes de recherche signalent les requêtes sans résultat et celles qui génèrent peu d’engagement. Lire les cinquante premières et se demander, pour chacune, quel attribut aurait permis d’y répondre est un exercice utile.
Dans vos trois plus grandes catégories, quels attributs descriptifs sont renseignés, et pour quelle part des produits ? La couverture des attributs de base est souvent élevée. Celle de l’occasion, de l’usage, de la coupe et de la compatibilité est en général bien plus faible, et ce sont justement les attributs dont dépendent les requêtes conversationnelles.
Où se trouve aujourd’hui l’information manquante ? Si elle est dans les photos, les systèmes produit, les documents ou les avis, elle peut être collectée. Si elle n’existe nulle part, il faut la créer, et le plan doit préciser qui s’en chargera.
Qui vérifie les attributs avant qu’ils n’arrivent dans la recherche, et comment ? Vérifier chaque fiche à la main ne tiendra pas à l’échelle qu’exige la recherche en langage naturel. Examinez de près les premiers résultats pour confirmer qu’ils sont justes, puis appuyez-vous sur des règles de validation qui contrôlent automatiquement chaque fiche et ne transmettent à une personne que les exceptions.
Comment allez-vous mesurer le résultat ? Les responsables avec qui nous avons échangé financent en général ce type de travail après un test mesuré : une partie définie du catalogue, une comparaison avec un groupe témoin et un résultat exprimé en chiffre d’affaires de la recherche par visiteur ou en taux de conversion de la recherche. Prévoir la mesure avant de commencer rend le résultat plus facile à exploiter.
Perspectives
La recherche en langage naturel et le commerce conversationnel évoluent vite, et les plateformes comprendront de mieux en mieux ce que veulent dire les acheteurs. Ce progrès devrait rendre l’état des données produit plus visible, et non moins. Une plateforme qui comprend précisément une demande montrera aussi clairement quand le catalogue ne peut pas y répondre.
Voyez comment vos propres données tiendraient
L’évaluation de la qualité des données d’atronous prend jusqu’à 50 SKU de votre PIM ou de votre ERP, tels qu’ils sont aujourd’hui, et les fait passer par le même pipeline que nos clients grands comptes. Sous cinq jours ouvrés, vous recevez l’échantillon en retour, généré et validé, avec les recommandations de taxonomie et de schéma qui sous-tendent le travail, ainsi qu’une séance de travail pour passer en revue ce que nous avons trouvé.
Demandez votre évaluation de la qualité des données, ou découvrez comment atronous travaille avec les marques de mode.
L’intelligence dans chaque attribut.
Questions fréquentes
Qu’est-ce que la recherche en langage naturel en e-commerce ?
C’est une recherche sur site qui interprète ce que veut dire l’acheteur, au lieu de se limiter aux mots qu’il a tapés. L’acheteur peut décrire un besoin, comme une robe pour un mariage en soirée ou une vanne prévue pour une pression donnée, et la plateforme identifie le type de produit et les qualités recherchées. La recherche conversationnelle va plus loin en permettant à l’acheteur d’affiner sa demande au fil de plusieurs échanges.
Pourquoi la recherche en langage naturel demande-t-elle plus de données produit que la recherche par mots-clés ?
Parce que l’acheteur peut poser une question sur n’importe quoi : l’occasion, la saison, la coupe, la compatibilité, l’usage d’un produit. Une recherche par mots-clés ou un filtre s’appuie sur un ensemble fixe de termes et de valeurs. Une requête en langage naturel ne peut être rapprochée que des produits dont la fiche décrit les qualités demandées, si bien que l’ensemble des attributs utiles est plus large et plus difficile à anticiper.
Une plateforme de recherche peut-elle déduire seule les attributs produit manquants ?
Dans une certaine mesure. Certaines plateformes génèrent des attributs à partir des descriptions et des images, ce qui aide. Elles ne peuvent déduire que ce qui figure dans le contenu qu’elles reçoivent, les résultats ne sont pas toujours vérifiés, et les attributs restent en général dans ce seul outil. Des attributs enregistrés et validés dans la fiche produit elle-même sont cohérents et peuvent être réutilisés par chaque canal qui la lit.
Quels attributs produit comptent le plus pour la recherche en langage naturel ?
Au-delà des attributs de base comme la taille, la couleur et la matière, les attributs qui répondent aux requêtes conversationnelles sont descriptifs : occasion, niveau de formalité, saison, coupe, entretien, usage prévu et, dans les catalogues industriels, des spécifications normalisées. Les relations entre produits et le vocabulaire que les clients emploient pour les décrire améliorent aussi la capacité d’une plateforme à répondre à une demande.