Tagging produit en e-commerce : à quoi ressemble un bon tagging
La plupart des recommandations sur le tagging s’arrêtent à des conseils du type : utilisez des tags descriptifs, veillez à leur cohérence, révisez-les régulièrement. Ce n’est pas une norme. C’est un vœu pieux. Un bon tagging produit, c’est un vocabulaire contrôlé, gouverné par catégorie, validé avant sa diffusion et lisible par les systèmes qui, de plus en plus, se chargent de la recherche.
Le tagging produit consiste à associer des libellés à une fiche produit pour que les personnes et les systèmes puissent la retrouver, la filtrer, la regrouper et l’exploiter en merchandising. Jusque-là, rien de controversé. Si tant de projets de tagging échouent sans bruit, ce n’est pas parce que les équipes contestent la définition. C’est parce que les tags sont, dans une fiche produit, ce qu’il y a de plus facile à créer et de plus difficile à gouverner : les catalogues en accumulent plus vite que quiconque ne peut les encadrer par une norme.
Le résultat est bien connu de quiconque a hérité d’un grand catalogue. Des milliers de tags, aucun vocabulaire derrière, des filtres qui renvoient les mauvais produits, et personne ne se risque à supprimer quoi que ce soit, au cas où quelque chose en dépendrait.
Un tag, un attribut et une catégorie sont trois choses différentes
L’essentiel de la confusion dans ce domaine vient du fait que l’on traite trois structures distinctes comme une seule. Elles ne sont pas interchangeables, et cette différence détermine si un catalogue peut passer à l’échelle.
Une catégorie est l’emplacement d’un produit dans une hiérarchie. Un produit occupe un seul nœud, et ce nœud détermine les règles qui s’appliquent à lui. C’est la taxonomie, et elle est structurelle.
Un attribut est un champ défini, avec un nom, un type de données, une unité le cas échéant et un ensemble de valeurs autorisées. La longueur de manche est un attribut. La tension électrique est un attribut. L’indice de colonne d’eau en millimètres est un attribut. Les attributs sont la référence sur laquelle les places de marché s’appuient pour valider, et ce que lisent les moteurs de comparaison.
Un tag est un libellé associé à une fiche pour la retrouver ou pour le merchandising. Il peut correspondre exactement à une valeur d’attribut, ou désigner quelque chose qu’aucun schéma d’attributs ne contiendrait jamais, comme un regroupement lié à une campagne saisonnière ou un indicateur interne de merchandising.
Les problèmes commencent quand les tags servent de substitut aux attributs au lieu de constituer une couche par-dessus. Un tag « waterproof » n’a pas la même valeur qu’un attribut qui enregistre un indice de colonne d’eau de 10 000 millimètres. Le premier est une affirmation. Le second est une spécification qu’un acheteur peut comparer et qu’un canal peut valider. Les catalogues qui mettent des affirmations là où il faudrait des spécifications finissent par ne plus pouvoir répondre aux questions qui décident des achats.
Là où le tagging déraille vraiment
Les modes de défaillance sont les mêmes d’une catégorie à l’autre, quelle que soit la taille de l’entreprise.
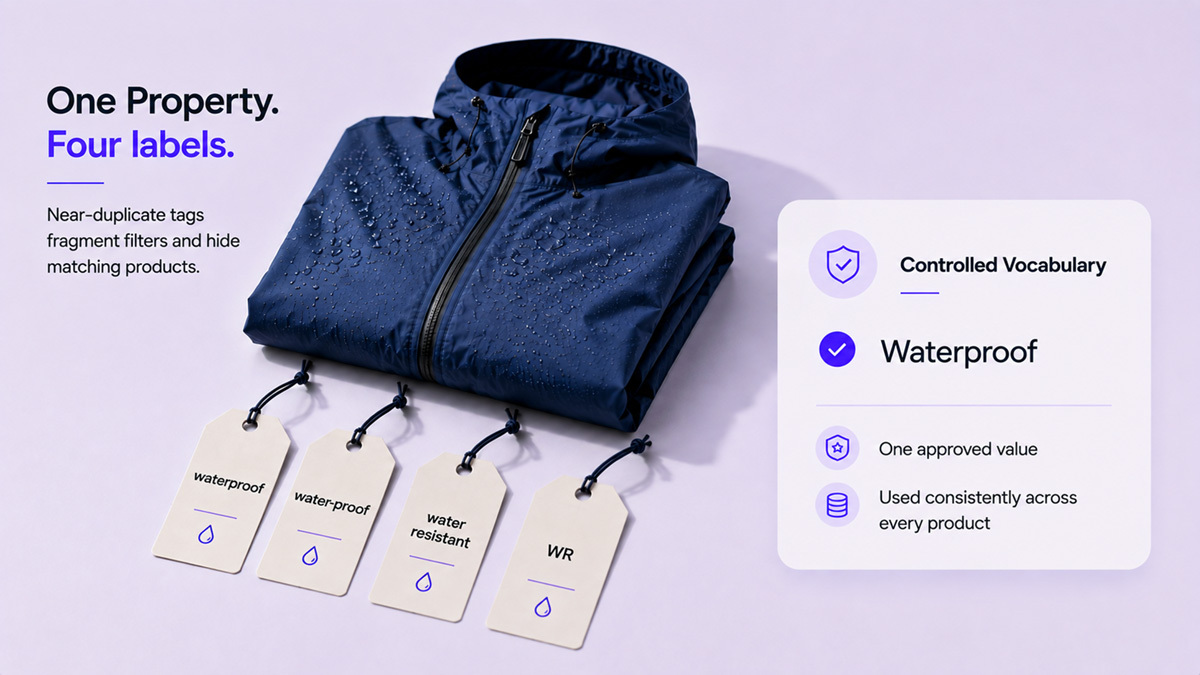
La saisie libre crée des quasi-doublons. Sans gouvernance, un même concept devient quatre libellés : « waterproof », « water-proof », « water resistant », « WR ». Chacun d’eux se défend. Ensemble, ils éclatent un filtre en quatre cases à cocher, dont aucune ne renvoie l’ensemble des produits correspondants. L’acheteur en conclut que vous proposez trois vestes imperméables alors que vous en avez soixante.
Les tags sont appliqués au mauvais niveau. Les tags de merchandising sont les coupables habituels, parce qu’ils sont appliqués en masse et rarement vérifiés au regard des variantes sous-jacentes. Le libellé « Déstockage » posé sur le produit parent alors que seules trois tailles sur onze sont réellement démarquées est techniquement exact et concrètement défaillant : l’acheteur filtre sur le déstockage, arrive sur la page et trouve la taille qu’il veut au prix fort. Tout ce qui varie selon la variante doit se situer au niveau de la variante, qu’il s’agisse d’un attribut ou d’un tag qui en est dérivé. Les erreurs de niveau sont invisibles dans un audit qui se contente de vérifier si un champ est renseigné.
Libellés marketing et valeurs factuelles partagent le même champ. « Meilleure vente », « Sélection été » et « Déstockage » se retrouvent dans le même champ de tags que la composition matière et le type de fermeture. Dès lors, aucun système en aval ne peut se fier à ce champ, car il ne sait pas distinguer un fait d’une campagne.
Rien n’est jamais retiré. Les tags sont créés en permanence et presque jamais supprimés. Des regroupements saisonniers vieux de trois ans subsistent. Des tags appliqués à deux produits chacun s’accumulent par milliers : aucun n’est utile pour filtrer, tous sont du bruit pour chaque système qui lit le champ.
Le vocabulaire dérive en silence. Un champ censé contenir douze valeurs autorisées en contient quatre cents, et personne ne s’en aperçoit, parce que rien dans le pipeline ne surveille leur nombre. C’est la défaillance qui s’aggrave le plus vite, et c’est aussi la plus facile à détecter, pour peu que quelqu’un s’y intéresse.
À quoi ressemble un bon tagging
Pour le dire simplement, cinq conditions doivent être réunies pour que le tagging vaille la peine à grande échelle.
- Un vocabulaire contrôlé, défini par catégorie. Chaque champ qui doit être fermé dispose d’une liste explicite de valeurs autorisées, et cette liste appartient à la catégorie plutôt qu’au catalogue dans son ensemble. La longueur de manche est un vocabulaire pertinent pour les vêtements d’extérieur et dénué de sens pour les ustensiles de cuisine. Une liste de tags unique et commune, appliquée à des centaines de catégories, garantit que l’essentiel en sera faux la plupart du temps.
- Des tags qui renvoient à des attributs partout où un attribut existe. Si une valeur peut s’exprimer sous forme d’attribut structuré, avec un type et une unité, elle doit l’être, et le tag doit en être dérivé plutôt que saisi indépendamment. Les tags dérivés restent cohérents avec la spécification. Les tags saisis indépendamment s’en éloignent en l’espace d’une saison.
- Le bon niveau, choisi délibérément. Produit, variante ou actif numérique. Chaque tag a besoin d’un niveau explicite, et ce niveau doit correspondre à la façon dont le canal et le site affichent le résultat. Cette seule décision règle la majorité des plaintes liées aux filtres dans un catalogue de mode ou de mobilier.
- Une provenance et un horodatage pour chaque valeur. D’où vient ce tag : d’un flux fournisseur, d’une passe de génération, d’un responsable merchandising ? Et quand ? Sans provenance, impossible de remonter d’une valeur erronée jusqu’à sa source, et une correction répare une fiche au lieu de la règle qui en a produit dix mille.
- Une validation avant que le tag n’atteigne un canal. Un tag hors du vocabulaire de sa catégorie, placé au mauvais niveau ou en contradiction avec un attribut structuré de la même fiche est un défaut : peu coûteux à détecter automatiquement, coûteux à découvrir après la mise en ligne. La génération et la validation sont deux tâches distinctes, et une même passe ne devrait jamais faire les deux.
Aucune de ces conditions ne consiste à produire davantage de tags. Chacune vise à donner aux tags que vous avez déjà un sens précis et stable.
Comment savoir si vos tags fonctionnent
La plupart des équipes mesurent le tagging à sa couverture, c’est-à-dire la part des produits qui portent des tags. La couverture est l’indicateur le moins informatif qui soit. Quatre mesures en disent beaucoup plus.
Taille du vocabulaire par rapport à la taille attendue. Comptez les valeurs distinctes de chaque champ fermé. Un champ conçu pour douze valeurs qui en contient quatre cents dérive, et le ratio vous indique à quel point.
Taux d’orphelins. La part des tags appliqués à moins d’une poignée de produits. Un taux d’orphelins élevé signifie que le vocabulaire est inventé au moment de la saisie au lieu d’être choisi dans une liste.
Rendement des filtres. La fréquence à laquelle une sélection de filtre ne renvoie aucun résultat, ou renvoie des produits qui n’ont rien à y faire. C’est la mesure la plus proche du chiffre d’affaires perdu, et elle est généralement disponible dans les outils d’analyse d’audience du site, sans instrumentation supplémentaire.
Taux de contradiction. La fréquence à laquelle un tag contredit un attribut structuré de la même fiche. Une fiche taguée « waterproof » sans attribut d’indice de colonne d’eau, ou taguée « coton » à côté d’un champ matière qui indique « polyester », est une fiche à laquelle aucun canal ni aucun agent ne devrait se fier.
Ces quatre mesures demandent plus de travail que la lecture d’un pourcentage de couverture. Ce sont aussi elles qui permettent de prédire si un produit sera trouvé, c’est-à-dire la dimension de la qualité des données que la plupart des tableaux de bord ignorent complètement.
Pourquoi c’est encore plus important avec l’arrivée des agents IA
Pendant l’essentiel de l’histoire de l’e-commerce, le lecteur d’un tag produit était une personne qui utilisait un filtre, et une personne sait contourner un vocabulaire incohérent. Elle essaie un autre filtre, ou elle fait défiler la page. À mesure que les agents IA prennent en charge une part croissante de la recherche et de la comparaison des produits, le lecteur est de plus en plus un système qui ne fait pas défiler. Il lit les valeurs structurées qu’on lui fournit et il calcule sur ces valeurs.
Dans ce contexte, quatre libellés quasi identiques pour une même propriété ne sont pas un simple désagrément. Ce sont quatre signaux plus faibles là où il devrait y en avoir un seul, fort, et un produit qui ne correspond pas nettement est un produit qui n’entre pas dans la comparaison. C’est là que le tagging cesse d’être une corvée de merchandising pour devenir l’une des conditions qui déterminent si un catalogue est lisible par les systèmes qui font les recommandations. La direction est claire, même si l’issue reste à écrire, et la préparation passe par le même travail qui améliore aujourd’hui le filtrage pour les humains.
À retenir
Le tagging n’est ni un exercice de contenu ni un problème de volume. C’est un problème de vocabulaire, surmonté d’une couche de gouvernance. Un catalogue doté de tags moins nombreux, bien définis et validés fait mieux qu’un catalogue qui en compte beaucoup, parce que chaque tag du premier signifie une seule chose et que chaque filtre construit dessus renvoie les bons produits.
atronous traite les tags comme toute autre valeur d’une fiche produit. Les valeurs sont générées dans l’espace où l’IA est performante, puis validées de façon déterministe selon le vocabulaire de la catégorie à laquelle elles appartiennent, au moyen d’une couche de contraintes qui couvre plus de 400 catégories de produits, chacune appliquée indépendamment. Une livraison type pour un grand compte fait ressortir 18 catégories distinctes d’anomalies de qualité des données et renvoie chacune avec sa justification, au lieu de l’écarter en silence. Les fiches vérifiées sont ensuite livrées au PIM, à l’ERP et aux systèmes en aval qui prennent le relais.
Commencez par une conversation sur vos données produit, ou envoyez un échantillon pour voir les problèmes de vocabulaire de votre propre catalogue mesurés et restitués.
L’intelligence dans chaque attribut.
Questions fréquentes
Qu’est-ce qu’un tag produit ?
Un tag produit est un libellé associé à une fiche produit pour que les personnes et les systèmes puissent la retrouver, la filtrer, la regrouper ou l’exploiter en merchandising. Un tag peut être dérivé d’une valeur d’attribut structurée, comme la couleur ou la matière, ou contenir quelque chose qu’aucun schéma d’attributs ne porterait, comme un regroupement saisonnier ou un indicateur interne de merchandising. La distinction compte : les tags servent à retrouver les produits, tandis que les attributs portent la spécification que les canaux valident et que les moteurs de comparaison lisent. Une propriété qui relève d’un attribut doit être enregistrée comme attribut, et le tag doit en être dérivé, jamais saisi indépendamment comme tag.
Quelle est la différence entre un tag produit et un attribut produit ?
Un attribut est un champ défini, avec un nom, un type de données, une unité le cas échéant et un ensemble de valeurs autorisées, comme un indice de colonne d’eau mesuré en millimètres. Un tag est un libellé utilisé pour la recherche et le merchandising, comme « Cadeau fête des Mères ». La bonne pratique consiste à dériver les tags des attributs partout où un attribut existe, afin que les deux ne puissent pas diverger. Utiliser des tags à la place des attributs revient à remplacer des spécifications comparables par des affirmations invérifiables.
Les tags produit sont-ils utiles au SEO ?
Des tags bien gouvernés aident indirectement, en améliorant la recherche interne, le filtrage et la structure des pages qui sont indexées. Des tags non gouvernés nuisent, car les valeurs quasi identiques fragmentent les pages de collection, créent des pages pauvres ou presque vides, et dispersent le signal sur plusieurs URL faibles au lieu d’une seule URL forte. Le facteur déterminant n’est pas le nombre de tags, mais le fait qu’ils proviennent ou non d’un vocabulaire contrôlé qui correspond fidèlement à la façon dont les acheteurs et les moteurs de recherche décrivent le produit.