Ce qu’un PIM ne fait pas
Dans presque toutes les évaluations techniques, quelqu’un pose une variante de la même question. Nous avons déjà une plateforme de gestion des informations produit. Pourquoi aurions-nous besoin d’autre chose. C’est la bonne question, et la plupart des réponses qu’on y apporte sont fausses, parce qu’elles affirment qu’un PIM ne peut pas faire des choses dont il est capable. Les plateformes modernes génèrent les valeurs manquantes, appliquent des règles par catégorie, gèrent les unités et les vocabulaires contrôlés, et dialoguent avec les places de marché dans les deux sens. La capacité existe.
Voici quatre cas où disposer de la capacité ne revient pas à obtenir le résultat. Non pas quatre choses qu’un PIM ne peut pas faire. Quatre choses qu’un PIM exige que vous fassiez.
Ce qu’un PIM est conçu pour faire, et qu’il fait bien
Il vaut la peine d’être précis sur ce point, car l’argument qui suit suppose de le prendre au sérieux.
Un PIM est un système de référence pour les informations produit. Sa mission première est de conserver, pour un produit, une version unique qui fait autorité, de modéliser les relations qui l’entourent et d’encadrer qui peut modifier quoi. Le modèle de données est le cœur du système : familles de produits, variantes, hiérarchies, valeurs localisées, relations entre articles et association des actifs numériques aux fiches. Construire correctement ce modèle est réellement difficile, et les plateformes matures ont mis de nombreuses années à y parvenir.
Autour du modèle s’organise la gouvernance. Les droits d’accès basés sur les rôles déterminent qui peut modifier quel attribut. Le workflow fait passer une fiche par les étapes d’affinage, de relecture et d’approbation. La gestion des versions enregistre qui a modifié une valeur et quand, et permet d’annuler une modification. Pour une organisation où responsables merchandising, traducteurs et responsables de canaux interviennent sur les mêmes fiches, ce n’est pas une lourdeur administrative. C’est la seule chose qui empêche le catalogue de devenir un document partagé que chacun écrase.
Vient ensuite la syndication. Un PIM prend les valeurs qu’il détient, les met en forme selon le modèle configuré pour chaque destination et les achemine, selon un calendrier défini, vers les places de marché, les portails détaillants, les boutiques en ligne et les systèmes en aval. Il suit ce qui est parti où et signale ce qui est revenu refusé.
Modéliser, gouverner, versionner, diffuser. Une plateforme qui accomplit ces quatre tâches de manière fiable sur un catalogue volumineux a de la valeur, et rien ici ne prétend le contraire.
Premier point : un PIM générera des valeurs. Il ne saura pas lesquelles sont justes.
Sur ce point, les choses ont changé, et quiconque avance encore cet argument n’a pas regardé un PIM moderne. Le remplissage génératif des champs est désormais intégré aux principales plateformes, branché sur le workflow, si bien qu’une valeur générée passe par la relecture et l’approbation comme n’importe quelle autre modification. Le problème de volume qui caractérisait autrefois ce travail est en grande partie résolu. Un responsable merchandising face à un déficit de complétude de 38 % n’a plus devant lui des mois de saisie.
Ce que le plugin apporte, c’est une réponse qui sonne juste. Un modèle chargé de remplir un champ de finition bois renvoie quelque chose qui ressemble à une finition bois, à chaque fois, pour chaque fiche, et il ne laisse jamais le champ vide. Ce n’est pas le modèle qui décide si la valeur est exacte. C’est la règle qui régit cet attribut dans cette catégorie, et le fait que quelque chose contrôle, ou non, le résultat au regard de cette règle.
La question de la génération n’est donc pas de savoir si la plateforme en est capable. Elle est de savoir au regard de quoi la valeur générée est contrôlée, et qui a écrit ce contrôle.
Deuxième point : les règles existent. Encore faut-il que quelqu’un les écrive.
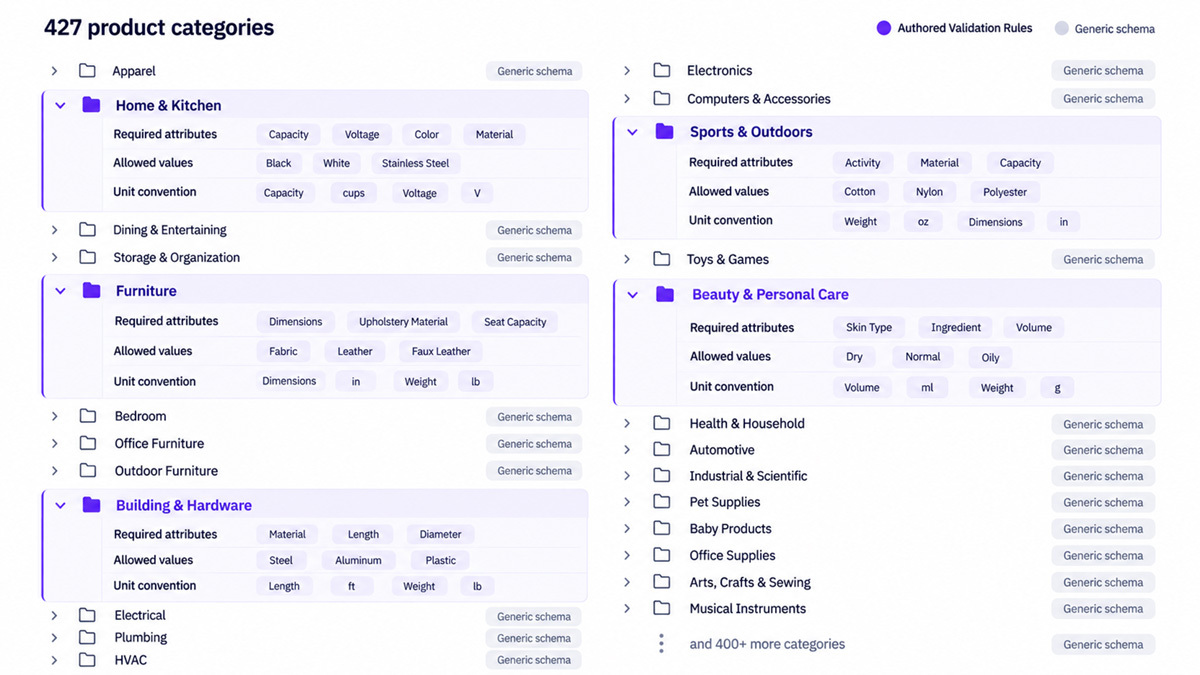
Les plateformes PIM gèrent correctement la validation par catégorie. Listes de valeurs, gestion des unités de mesure, règles de champs obligatoires et de complétude définies pour une catégorie plutôt que pour l’ensemble du catalogue. Un champ de finition bois limité à noyer, chêne, acajou et teck rejettera « marron ». Une longueur de conduit configurée en pieds détectera une valeur saisie en millimètres. Le mécanisme existe, et il fonctionne.
La contrainte n’est pas le mécanisme. La contrainte, c’est la rédaction des règles.
Chacune de ces règles est écrite par une personne. Quelqu’un décide quels attributs une catégorie exige, quelles sont les valeurs autorisées, quelle convention d’unités s’applique et en quoi les variantes peuvent différer. Ce travail est minutieux, il est lent, et il est propre à chaque catégorie. Le faire pour vingt catégories, c’est un projet avec une date de fin. Le faire pour quatre cents, c’est une charge permanente en effectifs, car le référentiel de règles du mobilier de bureau n’a presque rien en commun avec celui des instruments d’écriture, qui n’a lui-même presque rien en commun avec celui des centrales de traitement d’air.
Les règles finissent donc par être écrites pour les catégories qui posent le plus de problèmes, et le reste du catalogue fonctionne sur un schéma générique qui vérifie les types et les champs obligatoires, et guère plus. La validation n’est pas absente. Elle est inégale, et inégale à proportion de l’effort de configuration que chaque catégorie a reçu un jour. Demandez à une équipe qui gère un catalogue volumineux quelles catégories reposent sur de vraies règles : la réponse sera une courte liste, pas une liste complète.
Les règles vieillissent aussi. Elles encodent ce que quelqu’un comprenait d’une catégorie le jour où il les a écrites, et elles ne remarquent pas qu’une place de marché modifie ses exigences ou qu’un nouvel axe de variation devient la norme. Personne n’est responsable de quatre cents référentiels de règles. On est responsable des douze que l’on a construits, et mesurer honnêtement la qualité des données, c’est savoir quels sont ces douze.
Troisième point : un PIM exécute des mappings. Il ne les construit pas.
Ici, l’argument quitte le terrain où on l’attend, car ce point se joue en bout de chaîne plutôt qu’en début de chaîne.
Un PIM diffuse, et la syndication repose sur des modèles. Chaque destination a son modèle, qui indique quel attribut interne répond à quel champ obligatoire, comment les valeurs sont transformées en chemin, quelles unités sont converties, et comment un vocabulaire contrôlé de notre côté se traduit dans le vocabulaire contrôlé du leur.
Quelqu’un a dû construire ce modèle. Cette personne a lu la spécification de la destination, porté une longue série de jugements sur celui de nos attributs qui répond à tel ou tel de leurs champs, défini les transformations, géré les conversions d’unités, réconcilié les deux vocabulaires, testé le tout sur un échantillon, puis en a assumé la responsabilité. Ce travail, c’est le mapping. La plateforme exécute des mappings. Elle ne les produit pas.
Pour une entreprise qui vend sur quatre ou cinq destinations, c’est un projet gérable, fastidieux plus que difficile. Pour une marque qui vend à travers des centaines de modèles de détaillants, chacun avec ses propres champs obligatoires, ses propres vocabulaires, ses propres unités et sa propre idée de ce qu’est une couleur, la charge de configuration cesse d’être un projet et devient le travail permanent. Notre équipe européenne l’entend constamment de la part de marques qui le disent sans détour : le problème n’est pas de stocker les données produit, c’est qu’il existe des centaines de modèles et aucun moyen d’en faire le mapping à la main.
Si c’est un travail d’intelligence et non de transport, c’est parce qu’une décision de mapping est un jugement porté simultanément au regard de deux schémas et des règles d’une catégorie. Décider que notre « longueur de manche » répond à leur champ « manche », en centimètres plutôt qu’en pouces, et que notre valeur « trois quarts » devient leur valeur « manche 3/4 », suppose de savoir ce que l’attribut signifie dans cette catégorie, et pas seulement comment il s’appelle. C’est le même type de jugement que le travail de validation, appliqué à l’autre bout de la chaîne.
Quatrième point : remarquer n’est pas agir.
Les destinations modifient leurs exigences. Un détaillant ajoute un attribut obligatoire, renomme un champ, restreint un vocabulaire contrôlé, change de convention d’unités ou scinde un attribut en deux. Chacun le fait à son propre rythme, et aucun ne prévient.
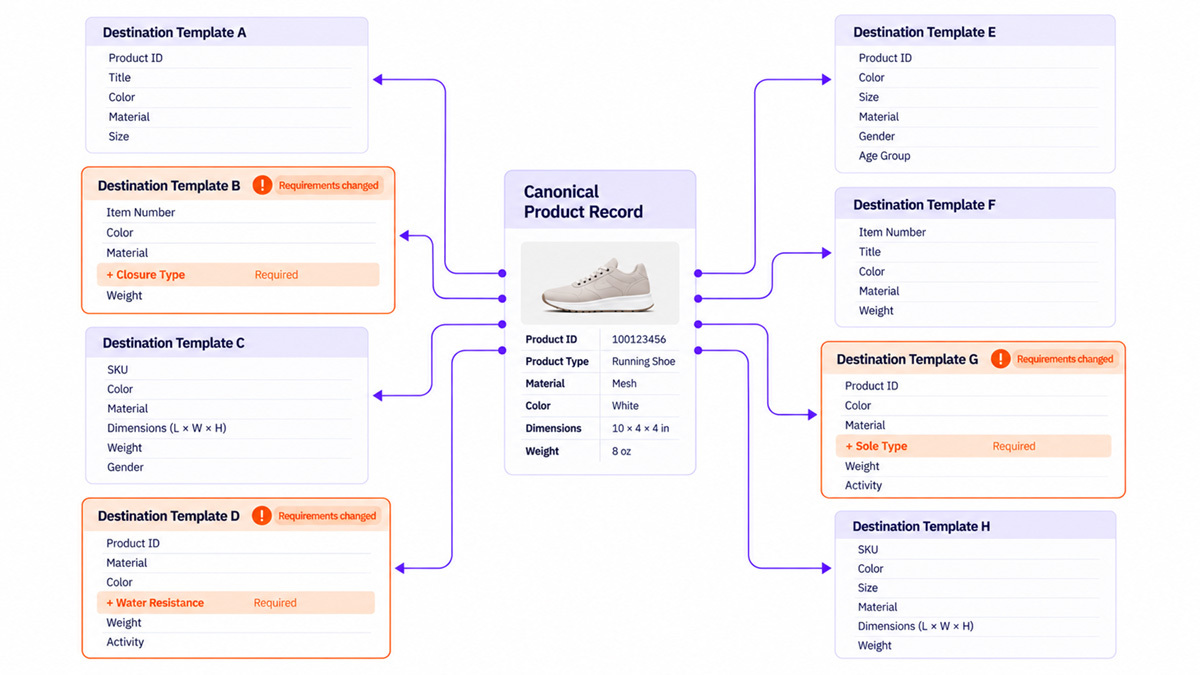
Ce point dépend de la plateforme, et les meilleures en font plus qu’on ne le leur reconnaît. Lorsqu’un PIM dispose d’une connexion API avec un détaillant ou une place de marché, cette connexion fonctionne généralement dans les deux sens. Le schéma peut être récupéré tout comme les données sont envoyées, ce qui signifie que la plateforme peut savoir que les exigences d’une destination ont changé, et le signaler.
La détection est la moitié la plus facile. Ce qui ne suit pas, c’est la correction. Savoir qu’un détaillant a ajouté un attribut obligatoire, scindé un champ en deux ou restreint un vocabulaire contrôlé ne renseigne pas le nouvel attribut dans quarante mille fiches concernées, ne décide pas comment l’ancienne valeur se reporte sur la nouvelle et ne complète pas rétroactivement l’historique. C’est un problème de mapping à refaire et un problème de génération qui arrivent ensemble, en volume, avec une échéance fixée par quelqu’un d’autre.
L’échec est donc plus circonscrit qu’il n’y paraît, et il se situe à un endroit plus frustrant. L’alerte se déclenche. Le travail qu’elle implique est manuel, et c’est le même jugement, catégorie par catégorie, que tout ce qui précède. atronous prend en charge la seconde moitié : lorsque le schéma d’une destination évolue, les attributs concernés font l’objet d’un nouveau mapping et sont régénérés selon la nouvelle exigence, au lieu d’être mis en file d’attente pour que quelqu’un les traite.
Quatre exigences, une seule architecture
La question intéressante n’est pas de savoir ce qui manque à un PIM, car, au vu de ces éléments, il lui manque très peu de chose. Elle est de comprendre pourquoi ces quatre tâches retombent toutes sur une personne, car ce n’est ni une coïncidence ni un oubli.
Un PIM est un logiciel SaaS de workflow. C’est la description d’une philosophie de conception, pas une critique, et c’est la bonne philosophie pour un système de référence. Un logiciel de workflow présente la bonne tâche à la bonne personne au bon moment, enregistre ce qu’elle a décidé, garantit que les étapes se déroulent dans l’ordre et en conserve la trace par la suite. Dans cette architecture, l’intelligence de chaque étape, c’est l’humain qui l’occupe. Le logiciel est la chorégraphie autour du jugement, pas le jugement lui-même.
Relisez les quatre points avec cela en tête : aucun n’est une lacune. Chacun correspond à l’architecture qui se comporte exactement comme prévu. Le PIM génère une valeur et la transmet à une personne, parce que décider si la valeur est juste est l’étape de l’humain. Il applique les règles de catégorie qu’une personne a rédigées, parce que les rédiger est l’étape de l’humain. Il exécute un mapping qu’une personne a construit. Il déclenche une alerte sur laquelle une personne agit ensuite. Rien ne manque. L’architecture suppose d’un bout à l’autre qu’une personne fournit le jugement, et elle excelle dans tout ce qui entoure cette hypothèse.
D’où la formulation la plus nette de la différence. Leur modèle : c’est vous qui faites. Le nôtre : c’est fait pour vous.
Ce n’est pas une comparaison de fonctionnalités, et cela ne se réduit pas à une telle comparaison. Toute la question est de savoir où se situe le jugement. Un système « fait par vous » évolue avec les effectifs, car chaque catégorie supplémentaire, chaque modèle supplémentaire et chaque canal supplémentaire ajoutent des étapes humaines, et ces étapes ne coûtent pas moins cher à mesure qu’elles se multiplient. Un système conçu pour fournir lui-même le jugement obéit à une autre arithmétique, et l’écart se creuse précisément dans les conditions qui décrivent un grand catalogue moderne : de nombreuses catégories, de nombreuses destinations et des exigences qui ne cessent de bouger.
Pas en amont. La couche intermédiaire
Il est tentant de décrire tout cela comme se situant en amont du PIM, et cette description est trop réductrice. « En amont » suppose une étape : les données sont préparées, puis transmises, puis le système de référence prend le relais. Une partie du travail fonctionne effectivement ainsi. La génération et la validation par catégorie ont lieu avant la livraison.
Le mapping vers le schéma d’une destination, non. La réaction aux changements de ce schéma, non plus. Les deux ont lieu en bout de chaîne, après que le système de référence a fait tout ce qu’il fait. Un cadrage qui place atronous à l’un des bouts de la chaîne ne peut pas décrire une capacité qui opère aux deux bouts.
La description exacte, c’est qu’atronous est la couche d’intelligence qui manque aux PIM. Pas une étape qui les précède. Le jugement que leur architecture attend d’une personne, fourni à la place par quelque chose de conçu pour le fournir, en plusieurs points du même pipeline, y compris des points situés de l’autre côté du système de référence par rapport à l’endroit où se trouverait une étape de préparation.
Concrètement, cela commence avant même qu’un PIM ait quoi que ce soit à gérer. Il s’agit d’ingérer les informations produit dans les formats où elles arrivent réellement, c’est-à-dire des fiches techniques, des manuels, des images, des dessins techniques, des fichiers CAO et des feuilles de calcul fournisseurs, plutôt qu’un flux propre. Il s’agit de normaliser ce qui en ressort, pour que onze fournisseurs qui décrivent le même attribut de onze façons différentes aboutissent à une seule valeur. Et il s’agit de rationaliser un catalogue unique et cohérent à partir de nombreux fichiers fournisseurs et vendeurs qui n’ont jamais été conçus pour concorder. C’est plus qu’un simple ajout de contenu, car une valeur générée est une valeur candidate, pas une réponse.
Ensuite, c’est une logique déterministe qui valide chaque valeur candidate selon les règles de la catégorie à laquelle appartient la fiche, une fois celle-ci classée dans la bonne catégorie, sur une couche de contraintes couvrant plus de 400 catégories. Chaque catégorie a son propre vocabulaire, ses conventions d’unités, ses axes de variation autorisés et ses règles d’identifiants, chacun appliqué indépendamment, si bien qu’une règle valable pour l’une ne peut pas contaminer une autre. La différence avec un référentiel de règles configuré, c’est que personne n’a à en rédiger quatre cents.
En bout de chaîne, il s’agit de générer les mappings vers les schémas des destinations au lieu d’attendre que quelqu’un les configure, et de surveiller ces destinations pour qu’une exigence modifiée donne lieu à un nouveau mapping et à une régénération, au lieu d’attendre dans une file qu’une personne s’en occupe.
Rien de tout cela ne fait de nous un système de référence, et nous ne sommes pas en train d’en devenir un. Le PIM continue de modéliser, gouverner, versionner et diffuser, ce qu’il fait bien. Ce qui change, c’est que le jugement que ces quatre fonctions attendent d’une personne est fourni par quelque chose de conçu pour cette tâche.
Le principe sous-jacent ne change pas : un sous-ensemble validé, avec des exceptions documentées, vaut mieux qu’un fichier complet aux erreurs cachées. Dix mille fiches vérifiées et un reliquat signalé, c’est un bon résultat. Treize mille fiches avec un taux d’erreur inconnu, c’est un problème qui apparaît après la mise en ligne.
Pourquoi c’est plus important aujourd’hui
Tant que le lecteur d’une fiche produit était une personne, une catégorie non configurée restait supportable. Un responsable merchandising qui connaît la catégorie lit une fiche pauvre ou incohérente, comprend ce qui s’est passé et contourne le problème. La tolérance à l’ambiguïté était intégrée à chaque étape du processus, parce que des personnes l’apportaient à chaque étape, ce qui est la même hypothèse que celle sur laquelle repose l’architecture de workflow.
À mesure que les agents IA prennent en charge une part croissante de la manière dont les produits sont trouvés, comparés et recommandés, cette tolérance disparaît aussi à l’autre bout. Un agent lit les valeurs structurées qu’on lui fournit et calcule sur ces valeurs. Il ne peut pas distinguer une valeur conforme à un schéma d’une valeur conforme aux règles de sa catégorie, et il n’a aucun moyen de contourner cette différence. Dans ce contexte, une fiche complète mais fausse est pire qu’une fiche visiblement incomplète, car l’incomplétude, au moins, se signale d’elle-même.
La symétrie mérite d’être relevée. L’architecture « fait par vous » supposait qu’une personne fournirait le jugement lors de la production. Les canaux auxquels elle livre supposaient qu’une personne fournirait l’interprétation lors de la consommation. Ces deux hypothèses tombent en même temps, et pour la même raison.
Voyez la différence, mesurée sur vos propres fiches
Le moyen le plus rapide de voir l’écart entre « renseigné » et « exact » dans votre propre catalogue est d’en faire mesurer un échantillon. C’est ce que fait l’évaluation de la qualité des données d’atronous. Envoyez jusqu’à 50 SKU extraits de votre PIM ou de votre ERP, exactement tels qu’ils vivent dans votre système, et nous les faisons passer par le même pipeline que celui sur lequel s’appuient nos clients grands comptes. Sous cinq jours ouvrés, vous recevez votre échantillon généré et validé, avec les recommandations de taxonomie et de schéma qui expliquent le travail, et une session de travail pour passer en revue ce que nous avons trouvé.
Sans argumentaire commercial. Vos propres fiches, mesurées selon les règles de leurs catégories.
Demandez votre évaluation de la qualité des données.
L’intelligence dans chaque attribut.
Questions fréquentes
Que fait un PIM ?
Une plateforme de gestion des informations produit (PIM) est un système de référence pour les données produit. Elle modélise les produits, les variantes, les hiérarchies, les valeurs localisées et les liens avec les actifs numériques ; elle gouverne qui peut modifier quel attribut, au moyen des droits d’accès, du workflow et de l’approbation ; elle versionne les modifications pour qu’elles puissent être auditées et annulées ; et elle diffuse les données vers les places de marché, les portails détaillants, les boutiques en ligne et les systèmes en aval, à l’aide d’un modèle configuré pour chaque destination. L’architecture a été conçue autour de ces quatre fonctions, et les plateformes matures les remplissent bien.
Un PIM peut-il générer les attributs produit manquants ?
Oui. Le remplissage génératif des champs est intégré aux principales plateformes et passe par le même workflow de relecture et d’approbation que toute autre modification ; le problème de volume qui caractérisait autrefois ce travail est donc en grande partie résolu. Ce que fournit la plateforme, c’est une valeur qui sonne juste, pas une valeur vérifiée. Un modèle chargé de remplir un attribut renvoie à chaque fois quelque chose de plausible et ne laisse jamais le champ vide : l’exactitude du résultat dépend donc entièrement de la règle qui sert à le contrôler, et du fait que quelqu’un ait, ou non, écrit cette règle pour la catégorie concernée.
Un PIM valide-t-il les données produit selon les règles de catégorie ?
Il le peut. Les plateformes PIM prennent en charge les listes de valeurs, la gestion des unités de mesure et les règles de champs obligatoires définies par catégorie ; bien configurées, elles détectent exactement les erreurs que l’on attend d’elles. La limite ne tient pas au mécanisme, mais à la rédaction des règles. Chaque règle est écrite par une personne, catégorie par catégorie, et une entreprise qui vend dans des centaines de catégories ne dispose pas de centaines de référentiels de règles tenus à jour. Elle a la douzaine que quelqu’un a construite pour les catégories qui posent le plus de problèmes, et un schéma générique partout ailleurs. La validation est inégale plutôt qu’absente, et inégale à proportion de l’effort de configuration.
Un PIM met-il les données produit en correspondance avec les modèles des places de marché et des détaillants ?
Il exécute des mappings. Il ne les crée pas. Chaque modèle de destination est configuré par une personne qui a lu la spécification, décidé quel attribut interne répond à quel champ obligatoire, défini les transformations et les conversions d’unités, et réconcilié les deux vocabulaires contrôlés. C’est gérable pour une poignée de destinations, et cela devient une charge permanente en effectifs quand il y en a des centaines. La décision de mapping elle-même est un jugement porté simultanément au regard de deux schémas et des règles d’une catégorie : c’est un travail d’intelligence, pas de transport.
Que se passe-t-il quand une place de marché modifie ses exigences en matière de données produit ?
Lorsqu’un PIM dispose d’une connexion API bidirectionnelle avec la destination, il peut souvent récupérer le schéma révisé et faire remonter le changement : la détection est donc fréquemment assurée. Ce qui ne suit pas, c’est la correction. Une alerte signalant qu’un détaillant a ajouté un attribut obligatoire ou scindé un champ en deux ne renseigne pas cet attribut dans les fiches concernées, ne décide pas comment les anciennes valeurs se reportent sur la nouvelle structure et ne complète pas rétroactivement l’historique. Refaire le mapping et générer les valeurs : ces deux problèmes arrivent ensemble, en volume, et c’est cette moitié du travail qui reste manuelle.
atronous remplace-t-il un PIM ?
Non, et ce n’est pas non plus une étape de préparation qui le précède. atronous fournit le jugement que l’architecture d’un PIM attend d’une personne. Il ingère les données produit dans les formats où elles arrivent réellement, les normalise entre des fournisseurs qui décrivent le même attribut différemment, et rationalise un catalogue unique à partir de nombreux fichiers vendeurs. Il valide ensuite chaque valeur selon les règles de sa catégorie, sur plus de 400 catégories, génère les mappings vers les schémas des destinations, puis refait le mapping et régénère les valeurs lorsqu’une destination modifie ses exigences. Une partie de ce travail a lieu avant que les données n’atteignent le système de référence, une autre après leur sortie. Le PIM continue de modéliser, gouverner, versionner et diffuser.