Lo que un PIM no hace
En casi todas las evaluaciones técnicas, alguien plantea alguna versión de la misma pregunta. Ya tenemos una plataforma de gestión de información de producto. ¿Por qué íbamos a necesitar algo más? Es la pregunta correcta, y la mayoría de las respuestas que se le dan son erróneas, porque afirman que un PIM no puede hacer cosas que sí puede hacer. Las plataformas modernas generan los valores que faltan, aplican reglas por categoría, gestionan unidades y vocabularios controlados, y se comunican con los marketplaces en ambos sentidos. La capacidad existe.
Lo que sigue son cuatro puntos en los que tener la capacidad no es lo mismo que obtener el resultado. No son cuatro cosas que un PIM no pueda hacer. Son cuatro cosas que un PIM le exige hacer a usted.
Lo que un PIM está diseñado para hacer, y hace bien
Conviene ser preciso en este punto, porque el argumento que sigue depende de tomarlo en serio.
Un PIM es un sistema de registro de la información de producto. Su función principal es conservar una única versión de referencia de un producto, modelar las relaciones que lo rodean y controlar quién puede cambiar qué. El modelo de datos es el núcleo de todo: familias de productos, variantes, jerarquías, valores localizados, relaciones entre artículos y la asociación de activos con registros. Construir bien ese modelo es realmente difícil, y las plataformas maduras han dedicado muchos años a conseguirlo.
Alrededor del modelo se sitúa la gobernanza. Los permisos basados en roles deciden quién puede editar cada atributo. El flujo de trabajo conduce un registro a través del refinamiento, la revisión y la aprobación. El versionado registra quién cambió un valor y cuándo, y permite revertir un cambio. Para una organización en la que responsables de merchandising, traductores y responsables de canal trabajan sobre los mismos registros, esto no es una carga administrativa. Es lo único que impide que el catálogo se convierta en un documento compartido que todos sobrescriben.
Luego está la sindicación. Un PIM toma los valores que contiene, les da formato según la plantilla configurada para cada destino y los envía, con una programación establecida, a marketplaces, portales de minoristas, tiendas en línea y sistemas de destino. Registra qué se envió a cada lugar y señala lo que volvió rechazado.
Modelar, gobernar, versionar, sindicar. Una plataforma que hace esas cuatro cosas de forma fiable en un catálogo grande es valiosa, y nada de lo que aquí se dice sostiene lo contrario.
La primera: un PIM generará valores. No sabrá cuáles son los correctos.
Este punto ha cambiado, y quien todavía lo use como argumento no ha visto un PIM moderno. El completado generativo de campos ya viene incluido en las principales plataformas, integrado en el flujo de trabajo para que un valor generado pase por revisión y aprobación como cualquier otra edición. El problema de volumen que antes definía este trabajo está en gran parte resuelto. Un responsable de merchandising ante una brecha de completitud del 38 % ya no tiene por delante meses tecleando valores.
Lo que aporta el complemento es fluidez. Un modelo al que se le pide completar un campo de acabado de madera devuelve algo que parece un acabado de madera, cada vez, en cada registro, y nunca deja el campo vacío. Que el valor sea correcto no lo decide el modelo. Lo decide la regla que rige ese atributo en esa categoría, y el hecho de que algo compare o no el resultado con ella.
Así que la cuestión de la generación no es si la plataforma puede hacerlo. Es con qué se compara el valor generado y quién escribió ese control.
La segunda: las reglas existen. Alguien tiene que escribirlas.
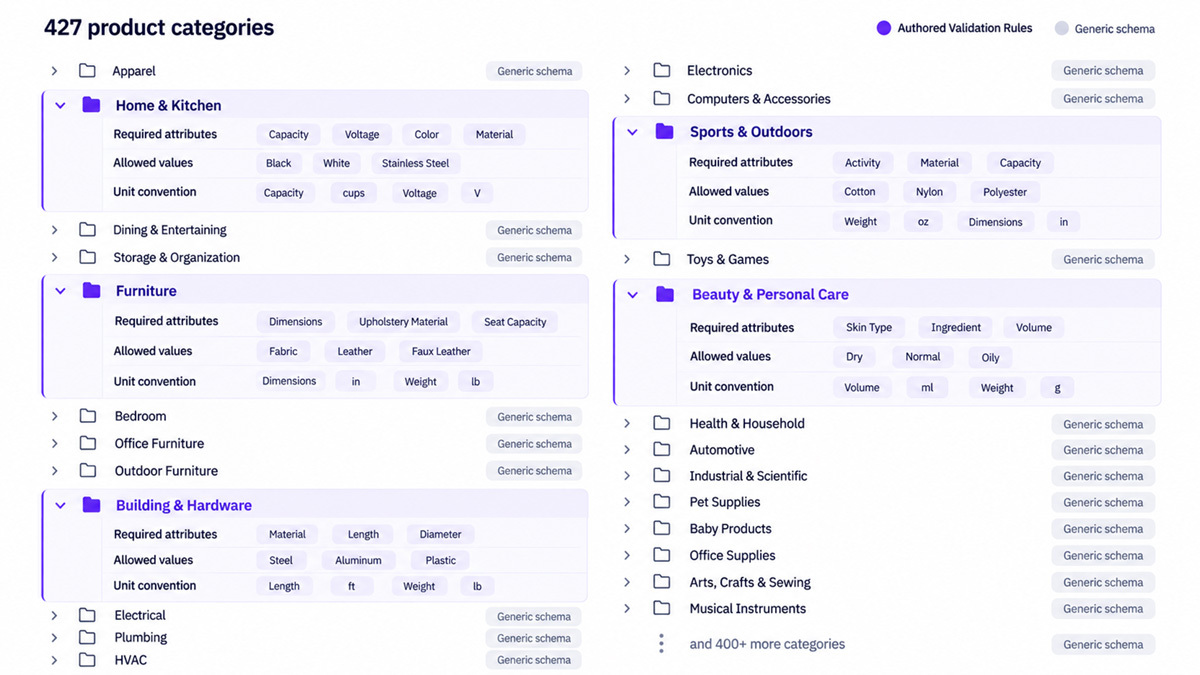
Las plataformas PIM admiten correctamente la validación por categoría. Listas de valores permitidos, gestión de unidades de medida, reglas de campos obligatorios y de completitud definidas para una categoría y no para todo el catálogo. Un campo de acabado de madera restringido a nogal, roble, caoba y teca rechazará “marrón”. Una longitud de conducto eléctrico configurada en pies detectará un valor expresado en milímetros. El mecanismo existe y funciona.
El mecanismo no es el factor limitante. El factor limitante es la redacción de las reglas.
Cada una de esas reglas la escribe una persona. Alguien decide qué atributos exige una categoría, cuáles son los valores permitidos, qué convención de unidades se aplica y en qué pueden diferir las variantes. Es un trabajo preciso, lento y propio de cada categoría. Hacerlo para veinte categorías es un proyecto con fecha de fin. Hacerlo para cuatrocientas es un compromiso permanente de personal, porque el conjunto de reglas del mobiliario de oficina no tiene casi nada en común con el de los instrumentos de escritura, que a su vez no tiene casi nada en común con el de las unidades de tratamiento de aire.
Así que las reglas se escriben para las categorías que más problemas causan, y el resto del catálogo funciona con un esquema genérico que comprueba tipos y campos obligatorios, y poco más. La validación no está ausente. Es desigual, y lo es en proporción al esfuerzo de configuración que haya recibido cada categoría. Pregunte a un equipo que gestiona un catálogo grande qué categorías tienen reglas reales detrás y la respuesta será una lista corta, no una completa.
Además, las reglas se deterioran. Codifican lo que alguien entendía de una categoría el día en que las escribió, y no se dan cuenta cuando un marketplace cambia sus requisitos o cuando una nueva dimensión de variante se vuelve estándar. Nadie se ocupa de cuatrocientos conjuntos de reglas. Las personas se ocupan de los doce que crearon, y medir la calidad de los datos con honestidad implica saber cuáles son esos doce.
La tercera: un PIM ejecuta mapeos. No los construye.
Aquí el argumento sale del terreno en el que se espera que esté, porque esto ocurre al final del proceso y no al principio.
Un PIM sindica, y la sindicación funciona con plantillas. Cada destino tiene una plantilla que indica qué atributo interno responde a cada campo obligatorio, cómo se transforman los valores por el camino, qué unidades se convierten y cómo un vocabulario controlado de nuestro lado se traduce al vocabulario controlado del lado del destino.
Alguien tuvo que construir esa plantilla. Leyó la especificación del destino, tomó una larga serie de decisiones sobre qué atributo nuestro responde a cada campo del destino, definió las transformaciones, resolvió las conversiones de unidades, concilió los dos vocabularios, la probó con una muestra y después se hizo cargo de ella. Ese trabajo es el mapeo. La plataforma ejecuta mapeos. No los produce.
Para una empresa que vende en cuatro o cinco destinos, es un proyecto abordable, más tedioso que difícil. Para una marca que vende a través de cientos de plantillas de minoristas, cada una con sus propios campos obligatorios, sus propios vocabularios, sus propias unidades y su propia idea de lo que es un color, la carga de configuración deja de ser un proyecto y se convierte en el trabajo permanente. Nuestro equipo europeo lo oye constantemente de marcas que lo dicen sin rodeos: el problema no es almacenar los datos de producto, sino que hay cientos de plantillas y ninguna forma de mapear hacia ellas a mano.
Esto es trabajo de inteligencia y no de transporte porque una decisión de mapeo es un juicio que se emite teniendo en cuenta dos esquemas y las reglas de una categoría a la vez. Decidir que nuestro “largo de manga” corresponde al campo “manga” del destino, en centímetros y no en pulgadas, y que nuestro valor “tres cuartos” debe expresarse allí como “manga 3/4”, exige saber qué significa el atributo en esta categoría, no solo cómo se llama. Es el mismo tipo de criterio que exige el trabajo de validación, aplicado en el otro extremo del proceso.
La cuarta: darse cuenta no es lo mismo que actuar.
Los destinos cambian sus requisitos. Un minorista agrega un atributo obligatorio, cambia el nombre de un campo, restringe un vocabulario controlado, modifica una convención de unidades o divide un atributo en dos. Cada uno lo hace según su propio calendario, y ninguno envía un aviso.
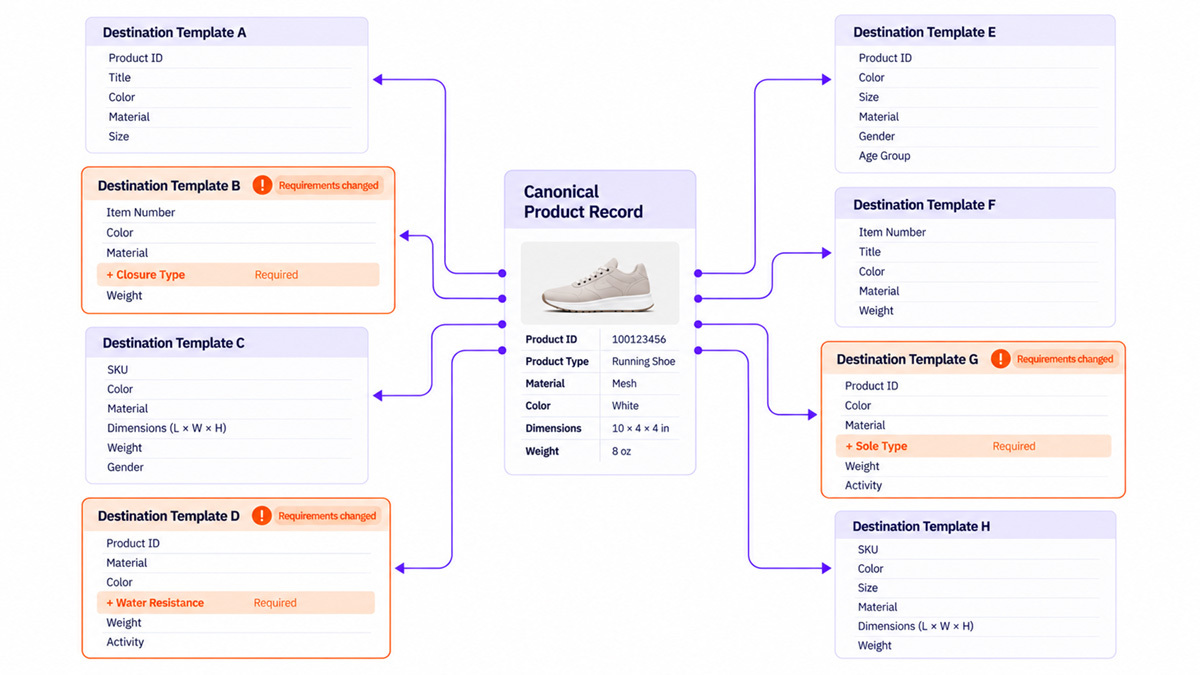
Esto depende de la plataforma, y las mejores hacen más de lo que se les reconoce. Cuando un PIM mantiene una conexión de API con un minorista o un marketplace, esa conexión suele funcionar en ambos sentidos. Se puede recuperar el esquema además de enviar los datos, lo que significa que la plataforma puede saber que los requisitos de un destino han cambiado y puede señalarlo.
La detección es la mitad más fácil. Lo que no se deriva de ella es la corrección. Saber que un minorista agregó un atributo obligatorio, dividió un campo en dos o restringió un vocabulario controlado no completa el nuevo atributo en cuarenta mil registros afectados, no decide cómo se corresponde el valor antiguo con el nuevo ni completa retroactivamente el historial. Es un problema de volver a mapear y un problema de generación que llegan juntos, a gran volumen y con un plazo fijado por un tercero.
Así que el fallo es más acotado de lo que parece a primera vista, y se produce en un punto más frustrante. La alerta salta. El trabajo que implica la alerta es manual, y requiere el mismo criterio por categoría que todo lo anterior. atronous cubre la segunda mitad: cuando el esquema de un destino cambia, los atributos afectados se vuelven a mapear y a generar según el nuevo requisito, en lugar de quedar en cola a la espera de que alguien los procese.
Cuatro requisitos, una sola arquitectura
La pregunta interesante no es qué le falta a un PIM, porque, a la vista de lo anterior, le falta muy poco. Es por qué estas cuatro tareas recaen en una persona, porque eso no es una casualidad ni un descuido.
Un PIM es software SaaS de flujos de trabajo. Esto describe una filosofía de diseño y no es una crítica, y es la filosofía adecuada para un sistema de registro. El software de flujos de trabajo presenta la tarea correcta a la persona correcta en el momento correcto, registra lo que decidió, garantiza que los pasos se sigan en orden y deja constancia de todo ello después. En esa arquitectura, la inteligencia de cada paso es la persona que lo ocupa. El software es la coreografía en torno al criterio, no el criterio.
Relea las cuatro con esto en mente y ninguna es una carencia. Todas son la arquitectura comportándose exactamente como se diseñó. Genera un valor y lo deriva a una persona, porque decidir si el valor es correcto es el paso de la persona. Aplica las reglas de categoría que redactó una persona, porque redactarlas es el paso de la persona. Ejecuta un mapeo que construyó una persona. Lanza una alerta sobre la que luego actúa una persona. No falta nada. La arquitectura da por hecho en todo momento que una persona aporta el criterio, y es excelente en todo lo que rodea esa premisa.
De ahí sale la formulación más clara de la diferencia: en su modelo, lo hace usted. En el nuestro, lo hacemos por usted.
No es una comparación de funciones, ni se reduce a una. Es una cuestión de dónde reside el criterio. Un sistema en el que lo hace usted escala con el número de personas, porque cada categoría adicional, cada plantilla adicional y cada canal adicional suman pasos humanos, y esos pasos no se abaratan al multiplicarse. Un sistema construido para aportar el criterio por sí mismo tiene otra aritmética, y la diferencia se acumula justo en las condiciones que describen un catálogo moderno de gran tamaño: muchas categorías, muchos destinos y requisitos que no dejan de cambiar.
No aguas arriba. La capa intermedia
Resulta tentador describir todo esto como algo situado aguas arriba del PIM, y esa descripción se queda corta. “Aguas arriba” implica una etapa: los datos se preparan, luego se entregan y, a partir de ahí, se encarga el sistema de registro. Parte del trabajo sí funciona así. La generación y la validación por categoría ocurren antes de la entrega.
El mapeo al esquema de un destino, no. La respuesta cuando ese esquema cambia, tampoco. Ambas cosas ocurren en el extremo final, después de que el sistema de registro haya hecho todo lo que hace. Un planteamiento que sitúa a atronous en un extremo de una línea no puede describir una capacidad que opera en los dos.
La descripción exacta es que atronous es la capa de inteligencia que les falta a los PIM. No una etapa anterior a ellos. El criterio que su arquitectura supone que aportará una persona, aportado en cambio por algo construido para aportarlo, en varios puntos del mismo proceso, incluidos puntos situados al otro lado del sistema de registro respecto de donde estaría una etapa de preparación.
En concreto, empieza antes de que un PIM tenga algo que gestionar. Significa ingerir la información de producto en los formatos en que realmente llega, es decir, fichas técnicas, manuales, imágenes, dibujos técnicos, archivos CAD y hojas de cálculo de proveedores, en lugar de un feed limpio. Significa normalizar lo que se obtiene para que once proveedores que describen el mismo atributo de once maneras distintas converjan en un solo valor. Y significa consolidar un único catálogo coherente a partir de muchos archivos de proveedores y vendedores que nunca se crearon para concordar entre sí. Eso es más que agregar contenido, porque un valor generado es un candidato, no una respuesta.
A partir de ahí, es la lógica determinista la que valida cada candidato según las reglas de la categoría a la que pertenece el registro, una vez clasificado en la categoría correcta, mediante una capa de restricciones que abarca más de 400 categorías. Cada categoría tiene su propio vocabulario, sus convenciones de unidades, sus dimensiones de variante permitidas y sus reglas de identificadores, y cada una se aplica de forma independiente para que una regla correcta para una categoría no pueda contaminar otra. La diferencia con un conjunto de reglas configurado es que nadie tiene que redactar cuatrocientos.
En el extremo final, significa generar los mapeos hacia los esquemas de destino en lugar de esperar a que alguien los configure, y vigilar esos destinos para que un requisito modificado se vuelva a mapear y a generar, en lugar de quedar en cola a la espera de que una persona lo procese.
Nada de esto nos convierte en un sistema de registro, y tampoco nos estamos convirtiendo en uno. El PIM sigue modelando, gobernando, versionando y sindicando, que es lo que hace bien. Lo que cambia es que el criterio que esas cuatro funciones suponen que aportará una persona lo aporta algo construido para esa tarea.
El principio de fondo no cambia: un subconjunto validado con excepciones documentadas vale más que un archivo completo con errores ocultos. Diez mil registros verificados y un resto señalado son un buen resultado. Trece mil registros con una tasa de error desconocida son un problema que aparece después de la puesta en línea.
Por qué esto importa más ahora
Mientras quien leía un registro de producto era una persona, una categoría sin configurar se podía sobrellevar. Un responsable de merchandising que conoce la categoría lee un registro escaso o incoherente, reconoce lo que ha pasado y lo sortea. La tolerancia a la ambigüedad estaba incorporada en cada parte del proceso, porque las personas la aportaban en cada paso, que es la misma premisa de la que parte la arquitectura de flujos de trabajo.
A medida que los agentes de IA asumen una parte mayor de la forma en que se encuentran, comparan y recomiendan los productos, esa tolerancia desaparece también en el otro extremo. Un agente lee los valores estructurados que recibe y los procesa. No sabe distinguir un valor que cumplió un esquema de un valor que cumplió las reglas de su categoría, y no tiene forma de sortear esa diferencia. En ese contexto, un registro completo y erróneo es peor que uno visiblemente incompleto, porque lo incompleto, al menos, se hace notar.
Vale la pena fijarse en la simetría. La arquitectura en la que lo hace usted daba por hecho que una persona aportaría el criterio durante la producción. Los canales a los que entrega los datos daban por hecho que una persona aportaría la interpretación durante el consumo. Ambas premisas están dejando de ser válidas al mismo tiempo, y por la misma razón.
Vea la diferencia medida en sus propios registros
La forma más rápida de ver cuánto se alejan “completado” y “correcto” en su propio catálogo es medir una muestra. Eso es lo que hace la Evaluación de Calidad de Datos de atronous. Envíe hasta 50 SKU desde su PIM o su ERP, tal como están en su sistema, y los pasamos por el mismo proceso en el que confían nuestros clientes empresariales. En un plazo de cinco días hábiles recibe la muestra generada y validada, junto con las recomendaciones de taxonomía y esquema que respaldan el trabajo y una sesión de trabajo para revisar lo que encontramos.
Sin discurso comercial. Sus propios registros, medidos según las reglas de sus categorías.
Solicite su Evaluación de Calidad de Datos.
Inteligencia en cada atributo.
Preguntas frecuentes
¿Qué hace un PIM?
Una plataforma de gestión de información de producto es un sistema de registro de los datos de producto. Modela productos, variantes, jerarquías, valores localizados y relaciones con los activos; gobierna quién puede cambiar cada atributo mediante permisos, flujos de trabajo y aprobaciones; versiona los cambios para que puedan auditarse y revertirse; y sindica los datos hacia marketplaces, portales de minoristas, tiendas en línea y sistemas de destino mediante una plantilla configurada para cada uno de ellos. La arquitectura se diseñó en torno a esas cuatro funciones, y las plataformas maduras las cumplen bien.
¿Puede un PIM generar los atributos de producto que faltan?
Sí. El completado generativo de campos viene incluido en las principales plataformas y pasa por el mismo flujo de revisión y aprobación que cualquier otra edición, de modo que el problema de volumen que antes definía este trabajo está en gran parte resuelto. Lo que aporta la plataforma es un valor fluido, no un valor verificado. Un modelo al que se le pide completar un atributo devuelve algo plausible cada vez y nunca deja el campo vacío, así que la exactitud del resultado depende por completo de la regla con la que se compara y de si alguien escribió esa regla para la categoría en cuestión.
¿Valida un PIM los datos de producto según las reglas de cada categoría?
Puede hacerlo. Las plataformas PIM admiten listas de valores permitidos, gestión de unidades de medida y reglas de campos obligatorios definidas por categoría, y bien configuradas detectan exactamente los errores que usted querría que detectaran. El límite no es el mecanismo, sino la redacción de las reglas. Cada regla la escribe una persona, categoría por categoría, y una empresa que vende en cientos de categorías no tiene cientos de conjuntos de reglas mantenidos al día. Tiene la docena que alguien creó para las categorías que más problemas causan y un esquema genérico en todas las demás. La validación no está ausente, sino que es desigual, y lo es en proporción al esfuerzo de configuración.
¿Mapea un PIM los datos de producto a las plantillas de marketplaces y minoristas?
Ejecuta mapeos. No los crea. Cada plantilla de destino la configura una persona que leyó la especificación, decidió qué atributo interno responde a cada campo obligatorio, definió las transformaciones y las conversiones de unidades, y concilió los dos vocabularios controlados. Eso es asumible con un puñado de destinos y se convierte en un compromiso permanente de personal cuando son cientos. La decisión de mapeo es en sí misma un juicio que se emite teniendo en cuenta dos esquemas y las reglas de una categoría al mismo tiempo, lo que la convierte en trabajo de inteligencia y no de transporte.
¿Qué ocurre cuando un marketplace cambia sus requisitos de datos de producto?
Cuando un PIM mantiene una conexión de API bidireccional con el destino, a menudo puede recuperar el esquema revisado y señalar el cambio, de modo que la detección suele estar resuelta. Lo que no se deriva de ello es la corrección. Una alerta de que un minorista ha agregado un atributo obligatorio o ha dividido un campo en dos no completa ese atributo en los registros afectados, no decide cómo se corresponden los valores antiguos con la nueva estructura ni completa retroactivamente el historial. Es un problema de volver a mapear y de generar que llega todo junto y a gran volumen, y es la mitad que sigue siendo manual.
¿Es atronous un sustituto del PIM?
No, y tampoco es una etapa de preparación previa a un PIM. atronous aporta el criterio que la arquitectura de un PIM supone que aportará una persona. Ingiere los datos de producto en los formatos en que realmente llegan, normaliza la información de proveedores que describen el mismo atributo de forma distinta y consolida un único catálogo a partir de muchos archivos de vendedores. Después valida cada valor según las reglas de su categoría, en más de 400 categorías, genera los mapeos hacia los esquemas de destino, y vuelve a mapear y a generar cuando un destino cambia sus requisitos. Parte de ese trabajo ocurre antes de que los datos lleguen al sistema de registro y parte después de que salen de él. El PIM sigue modelando, gobernando, versionando y sindicando.