Les agents ne sont jamais plus fiables que les systèmes derrière eux
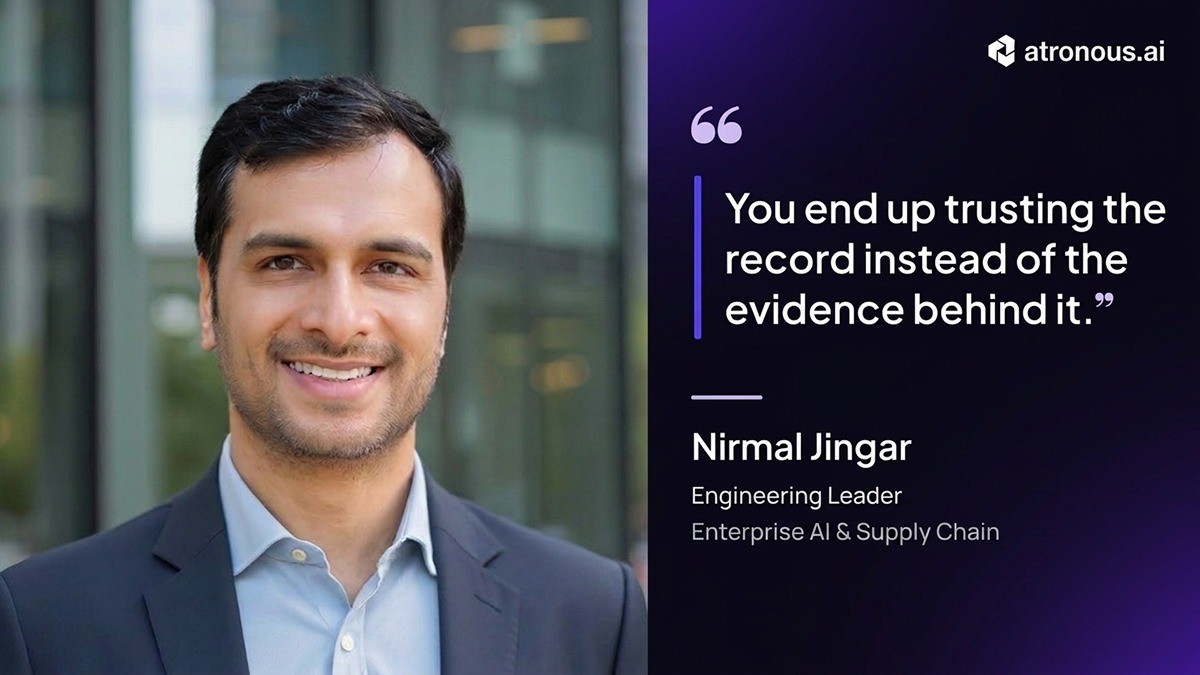
Un entretien avec Nirmal Jingar, responsable senior de l’ingénierie pour l’IA d’entreprise et la chaîne d’approvisionnement chez Wayfair.
Quand nous évaluons un catalogue, une dimension reçoit moins d’attention que les autres, et c’est celle sur laquelle je reviens sans cesse. La provenance et la traçabilité : chaque fiche portant un journal des modifications versionné, chaque règle consignée avec sa date, sa source et sa justification.
Une fiche correcte aujourd’hui, sans trace de la raison pour laquelle elle est correcte, est une fiche que vous ne pourrez pas défendre demain. À mesure que la décision d’achat se déplace vers le logiciel, cela cesse d’être un raffinement de gouvernance. Cela devient ce qui décide si un système peut, tout simplement, être digne de confiance.
Alors plutôt que d’écrire une fois de plus sur le sujet, je suis allée interroger quelqu’un qui a dû construire pour y répondre.
Nirmal Jingar a passé sa carrière à construire des systèmes de chaîne d’approvisionnement de premier plan, couvrant les achats, le routage, le calcul des dates de livraison et la planification du réseau. Il est responsable senior de l’ingénierie pour l’IA d’entreprise et la chaîne d’approvisionnement chez Wayfair, membre du Forbes Technology Council et intervenant TEDx ; il a récemment donné une conférence principale sur la chaîne d’approvisionnement cognitive. Il a aussi publié en open source typedguard, une couche de gouvernance conçue pour empêcher la manipulation des agents d’achat IA par injection de prompt.
Tous ceux qui construisent aujourd’hui dans le commerce agentique se précipitent pour livrer l’agent. Beaucoup plus rares sont ceux qui posent la question difficile qui se cache dessous : que se passe-t-il quand cet agent lit une fiche produit sans aucun moyen de savoir quels champs ont réellement été vérifiés ?
Voici ce qu’il m’a répondu.
La conversation
Quel est aujourd’hui le plus grand problème opérationnel caché ?
Ce n’est pas une défaillance de système, c’est une défaillance de décision. La plupart des organisations fonctionnent encore avec des processus manuels, non consignés, et le contexte derrière ces décisions vit dans la tête des gens, pas dans un système. Tout le monde parle de dette technique. Presque personne ne parle de dette opérationnelle : le coût accumulé des décisions que personne n’a notées, prises par des personnes autour desquelles on ne peut plus automatiser, parce qu’il n’y a rien sur quoi pointer l’automatisation.
Pourquoi l’information est-elle désormais aussi importante que les stocks ?
Le stock n’est plus seulement un bien physique, c’est une représentation numérique. Un logiciel ne voit pas un canapé comme un canapé. Il voit une configuration d’emballage, dérivée de dimensions, d’un poids et d’une douzaine de contraintes. Rendre cette représentation exacte à 100 % compte énormément, parce que les petites incohérences s’additionnent. Si un système a la mauvaise hauteur, la mauvaise largeur ou le mauvais poids dans ses fichiers, vous finissez par payer les mauvais frais de transporteur, par atteindre des limites de capacité que vous n’aviez pas prévues, ou par montrer aux clients des dimensions qui ne correspondent pas à ce qui arrive réellement. Dans l’e-commerce, tout repose sur la confiance. Perdez-la, et vous perdez quelque chose de très difficile à regagner.
Pourquoi l’IA dépend-elle de données de haute qualité ?
La qualité des données est fondamentale, mais pour les systèmes agentiques, ce qui me préoccupe de plus en plus, c’est la qualité du contexte. Un agent peut disposer de données parfaitement exactes et prendre quand même la mauvaise décision s’il ne comprend pas les contraintes métier qui entourent ces données.
C’est pourquoi je pense que les entreprises doivent aller au-delà des pipelines de données, vers des systèmes de contexte : des mécanismes qui capturent non seulement ce qu’est une valeur, mais d’où elle vient, le niveau de confiance qu’on lui accorde, les règles métier qui s’y appliquent et les décisions qu’il est prudent d’automatiser. On peut corriger de mauvaises données. Ce qui est plus difficile, c’est de construire la couche de contexte métier qui permet à un agent, ou à un système d’orchestration au-dessus de lui, de prendre réellement la bonne décision avec les données dont il dispose. De bonnes données sans contexte métier produisent encore de mauvaises décisions.
Un système n’a aujourd’hui aucun moyen de savoir quels champs d’une fiche produit ont réellement été vérifiés et lesquels ont été remplis à la hâte. Comment corriger cela ?
C’est au fond le problème de la provenance, et il rejoint la question de la profondeur de décision que j’évoquais plus tôt. Si l’origine d’un champ, son statut de vérification et son niveau de confiance ne sont pas capturés au moment de la saisie, il n’y a aucun moyen de reconstituer cette confiance plus tard. On finit par faire confiance à la fiche plutôt qu’aux preuves derrière elle. La solution n’est pas un tableau de bord plus grand : c’est de construire le système pour que la provenance soit capturée par défaut, et non ajoutée après coup.
Pourquoi les processus manuels d’information produit existent-ils encore ?
Parce qu’une grande partie du secteur fonctionne encore avec des feuilles Excel, des documents annexes et des messages ponctuels à un interlocuteur chez le transporteur : des décisions non systématiques, prises au cas par cas. Avant d’introduire l’IA ou l’automatisation dans un tel environnement, la priorité doit être de connecter les systèmes de bout en bout, pour disposer d’une visibilité complète et d’un flux d’information traçable qui ne dépend pas de quelqu’un qui pense à le transmettre.
En tant que dirigeant, comment obtenez-vous l’adhésion des équipes métier à des workflows plus automatisés ?
Je ne commence pas par une suggestion. J’essaie d’abord de comprendre ce qui leur fait réellement mal, pour qu’elles aient le sentiment qu’on résout leur problème, pas qu’on leur impose un système. L’automatisation change les workflows, les responsabilités et parfois le sentiment de contrôle qu’ont les gens sur un processus. L’adoption dépend donc de la confiance. Je commence par un problème douloureux que le métier veut déjà voir résolu, je livre une amélioration visible, je mesure le résultat, et j’étends à partir de là. Le message doit être « ceci vous aide à prendre de meilleures décisions », pas « cette technologie vous remplace ».
Cela vaut aussi pour la façon dont les équipes métier essaient de résoudre les choses elles-mêmes. Quelqu’un dira : « J’ai construit un workflow avec un outil. Vous pouvez juste le brancher sur la chaîne d’approvisionnement ? » Mais cette seule connexion peut toucher dix autres systèmes. C’est exactement là qu’un responsable de l’ingénierie doit intervenir : non pas pour dire non, mais pour s’assurer qu’une solution locale ne devienne pas un passif caché trois systèmes plus loin.
Que devraient mesurer les dirigeants ?
Résistez à l’envie d’inventer un nouveau tableau de bord pour chaque initiative agentique. Commencez par les indicateurs métier qui comptent déjà : les coûts, les délais de livraison, la rotation des stocks, la récupération, le respect des SLA, l’expérience client. Si un système agentique crée une valeur réelle, ces chiffres doivent bouger.
Je n’ajouterais qu’une seule catégorie nouvelle : la qualité de décision. À quelle fréquence le système a-t-il pris la bonne décision ? À quelle fréquence un humain l’a-t-il corrigé ? À quelle fréquence a-t-il correctement reconnu qu’il n’avait pas assez de confiance pour agir ?
Le secteur n’a pas besoin de dizaines de nouveaux indicateurs d’IA. Il a besoin que l’IA améliore les indicateurs métier qui comptent déjà pour les entreprises.
Quelle est votre définition du commerce agentique, et qu’est-ce qu’il n’est pas ?
Le commerce agentique commence quand un logiciel peut poursuivre un véritable objectif commercial, qu’il s’agisse de récupération maximale, d’expérience client ou de capacité des sites, à travers une séquence de décisions, et pas seulement une transaction isolée. La valeur n’est pas dans le mot « agent ». Elle est dans la capacité du système à naviguer entre les variables et à opérer à l’intérieur de garde-fous pour atteindre réellement cet objectif.
Ce qu’il n’est pas : un remplacement pur et simple du SaaS. Les systèmes d’entreprise comme SAP portent des années de logique métier et de gouvernance qui ne vont pas disparaître. Ce travail a déjà été fait, et le refaire n’est pas le sujet. Les systèmes agentiques fonctionnent mieux en complément : ils prennent en charge des tâches spécialisées qui rendent le système existant plus rapide et plus précis, au lieu de le remplacer.
Quand une entreprise devrait-elle construire un workflow agentique en interne plutôt que l’acheter à un éditeur ?
Ce débat précède l’IA et il ne disparaîtra pas à cause d’elle. Avez-vous les talents d’ingénierie en interne ? Pouvez-vous réellement le construire dans les délais dont vous avez besoin, surtout si vous voulez être le premier sur le marché ? Une erreur que je vois souvent consiste à supposer que l’accès à un modèle de fondation puissant élimine le travail d’ingénierie difficile. Ce n’est pas le cas. Les systèmes agentiques de production exigent toujours une connaissance approfondie du domaine, de l’intégration de systèmes, de l’évaluation, de l’observabilité, de la sécurité et de la gouvernance. Le modèle n’est qu’un composant de l’architecture.
Une prédiction pour les prochaines années ?
La provenance des données cesse d’être un journal réactif que l’on consulte après une panne, et devient une couche standard et proactive. Vous saurez qui a changé une valeur et d’où elle vient avant qu’elle ne cause un problème, pas après. Les systèmes évoluent vers l’autoréparation : ils signalent de manière proactive que quelque chose va mal tourner et suggèrent le correctif avant que cela n’arrive. Et les décisions deviennent plus déterministes : des règles, de la gouvernance et des juges de validation disposés autour du LLM, avec une boucle de retour vers le système. La qualité et la traçabilité sont ce qui séparera les systèmes auxquels les gens font vraiment confiance de ceux qu’ils se contentent de tolérer.
Un conseil pour les dirigeants de la chaîne d’approvisionnement ?
N’essayez pas de construire une stratégie d’IA pour l’ensemble de vos opérations d’un seul coup. Posez une question plus étroite : quelles décisions précises êtes-vous réellement prêt à confier à une machine ? Choisissez un cas d’usage, rendez-le entièrement agentique et apprenez de lui : surveillez-le, prouvez l’impact métier, et construisez seulement ensuite la pièce suivante. C’est une approche Lego : un bloc prêt pour la production à la fois. Les modèles changent vite, mais les décisions dont votre activité a réellement besoin changent beaucoup moins vite.
Ce que j’en retiens
Trois choses me sont restées.
La dette opérationnelle est le meilleur nom pour le problème. Nous le décrivons d’habitude comme des données manquantes. Nirmal le décrit comme des décisions que personne n’a consignées, ce qui est plus précis et plus inconfortable. Cela signifie que le manque n’est pas dans le catalogue. Il est dans tout ce qui a été décidé autour du catalogue et jamais enregistré.
La qualité du contexte est une distinction réelle, et ce n’est pas celle que font la plupart des gens. Des données exactes qu’un agent interprète mal parce qu’il ne connaît pas la contrainte qui les entoure restent une mauvaise décision. Nous retombons sur le même constat, abordé par l’autre bout : un champ peut être correct et violer malgré tout la règle qui gouverne sa catégorie.
La provenance passe du statut de piste d’audit à celui de condition préalable. Sa prédiction est qu’elle devient proactive plutôt que réactive : connue avant le problème plutôt que reconstituée après. S’il a raison, un catalogue incapable de dire d’où vient une valeur n’est pas simplement négligé. Il est inutilisable par les systèmes qui feront les achats.
Voyez ce que votre catalogue peut prouver
Si vous êtes responsable de données produit à grande échelle, nous proposons une évaluation gratuite de la qualité des données. Envoyez-nous un échantillon de votre catalogue et nous vous renvoyons un rapport sur ce que nous y trouvons : les identifiants défaillants, les erreurs de catégorie et les incohérences que votre équipe ne peut pas voir, parce qu’elle remplit les champs comme le modèle le demandait. Sans aucun engagement.
Obtenez votre évaluation de la qualité des données
Merci à Nirmal Jingar pour son temps et sa franchise. Vous pouvez suivre son travail sur LinkedIn.