Los agentes son tan fiables como los sistemas que los respaldan
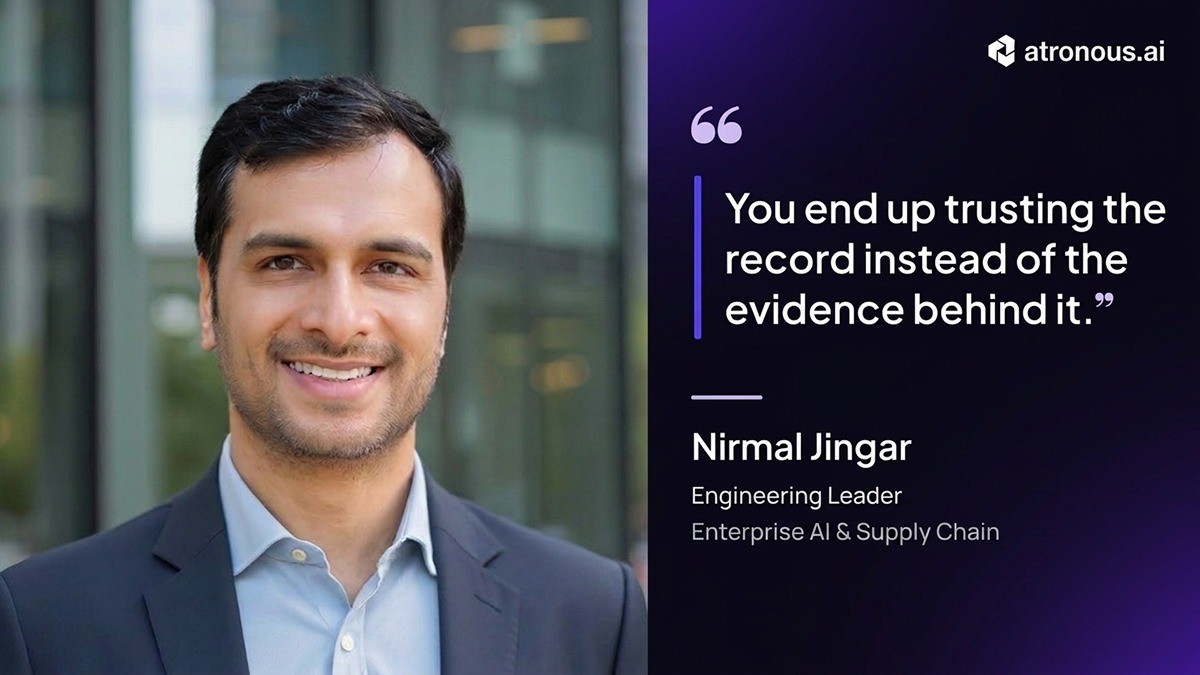
Una conversación con Nirmal Jingar, líder sénior de ingeniería de IA empresarial y cadena de suministro en Wayfair.
Cuando evaluamos un catálogo, hay una dimensión que recibe menos atención que las demás, y es a la que siempre vuelvo. La procedencia y la trazabilidad: cada registro con un historial de cambios versionado, cada regla documentada con su fecha, su fuente y su justificación.
Un registro que hoy es correcto, sin constancia de por qué es correcto, es un registro que mañana no se puede defender. A medida que una parte mayor de la decisión de compra pasa al software, eso deja de ser un detalle de gobernanza. Se convierte en lo que decide si un sistema puede ser fiable o no.
Así que, en lugar de volver a escribir sobre el tema, fui a preguntarle a alguien que ha tenido que construir para resolverlo.
Nirmal Jingar ha dedicado su carrera a construir sistemas de cadena de suministro de primer nivel, que cubren compras, enrutamiento, cálculo de fechas de entrega y planificación de la red. Es líder sénior de ingeniería de IA empresarial y cadena de suministro en Wayfair, miembro del Forbes Technology Council y ponente de TEDx; hace poco dio una conferencia magistral sobre la cadena de suministro cognitiva. También ha publicado como código abierto typedguard, una capa de gobernanza creada para impedir que los agentes de compras con IA sean manipulados mediante inyección de prompts.
Todos los que construyen hoy en el comercio agéntico corren por lanzar el agente. Muchos menos se hacen la pregunta más difícil que hay debajo: ¿qué pasa cuando ese agente lee un registro de producto y no tiene forma de saber qué campos se verificaron realmente?
Esto es lo que me contó.
La conversación
¿Cuál es hoy el mayor problema operativo oculto?
No es que falle un sistema: es que falla una decisión. La mayoría de las organizaciones todavía funcionan con procesos manuales, sin documentar, y el contexto detrás de esas decisiones vive en la cabeza de las personas, no en ningún sistema. Todo el mundo habla de deuda técnica. Casi nadie habla de deuda operativa: el gasto acumulado de las decisiones que nadie dejó por escrito, tomadas por personas a cuyo alrededor ya no se puede automatizar, porque no hay nada en que apoyar la automatización.
¿Por qué la información es ahora tan importante como el inventario?
El inventario ya no es solo un bien físico: es una representación digital. El software no ve un sofá como un sofá. Ve una configuración de embalaje, derivada de dimensiones, peso y una docena de restricciones. Lograr que esa representación sea 100 % exacta importa muchísimo, porque las pequeñas inconsistencias se acumulan. Si un sistema tiene registrada una altura, una anchura o un peso equivocados, usted termina pagando la tarifa de transporte equivocada, chocando con límites de capacidad que no había previsto o mostrando a los clientes dimensiones que no coinciden con lo que de verdad llega. En el e-commerce todo se basa en la confianza. Piérdala, y pierde algo muy difícil de recuperar.
¿Por qué la IA depende de datos de alta calidad?
La calidad de los datos es fundamental, pero en los sistemas agénticos me preocupa cada vez más la calidad del contexto. Un agente puede tener datos perfectamente exactos y aun así tomar la decisión equivocada si no entiende las restricciones de negocio que rodean esos datos.
Por eso creo que las empresas necesitan ir más allá de los pipelines de datos, hacia sistemas de contexto: mecanismos que capturan no solo cuál es un valor, sino de dónde proviene, cuánta confianza le tenemos, qué reglas de negocio se le aplican y qué decisiones es seguro automatizar. Los datos malos se pueden corregir. Lo más difícil es construir la capa de contexto del dominio que permite que un agente, o un sistema de orquestación por encima de él, tome de verdad la decisión correcta con los datos que tiene. Los buenos datos sin contexto del dominio siguen produciendo malas decisiones.
Un sistema hoy no tiene forma de saber qué campos de un registro de producto se verificaron realmente y cuáles se completaron con prisa. ¿Cómo lo solucionamos?
Este es, en el fondo, el problema de la procedencia, y está conectado con la cuestión de la profundidad de decisión que mencioné antes. Si el origen de un campo, su estado de verificación y su nivel de confianza no se capturan en el momento de la entrada de datos, no hay forma de reconstruir esa confianza después. Uno termina confiando en el registro y no en la evidencia que lo respalda. La solución no es un panel de control más grande: es construir el sistema para que la procedencia se capture por defecto, no añadida después.
¿Por qué siguen existiendo procesos manuales de información de producto?
Porque buena parte del sector todavía funciona con hojas de Excel, documentos sueltos y mensajes puntuales a un representante del transportista: decisiones no sistemáticas, tomadas sobre la marcha. Antes de introducir IA o automatización en ese entorno, la prioridad tiene que ser conectar los sistemas de extremo a extremo, para que haya visibilidad completa y un flujo de información trazable que no dependa de que alguien se acuerde de transmitirla.
Como líder, ¿cómo consigue que los equipos de negocio adopten flujos de trabajo más automatizados?
No empiezo con una sugerencia. Primero trato de entender qué les está causando dolor realmente, para que sientan que se está resolviendo su problema, no que se les impone un sistema. La automatización cambia los flujos de trabajo, las responsabilidades y, a veces, la sensación de control de las personas sobre un proceso. Así que la adopción depende de la confianza. Empiezo con un problema doloroso que el negocio ya quiere resolver, entrego una mejora visible, mido el resultado y amplío desde ahí. El mensaje debe ser “esto le ayuda a tomar mejores decisiones”, no “esta tecnología lo reemplaza”.
Eso también aplica a cómo los equipos de negocio intentan resolver las cosas por su cuenta. Alguien dirá: “Construí un flujo de trabajo con una herramienta. ¿Pueden conectarlo a la cadena de suministro?”. Pero esa única conexión puede tocar otros diez sistemas. Ahí es exactamente donde un líder de ingeniería tiene que intervenir: no para decir que no, sino para asegurarse de que un arreglo local no se convierta en un pasivo oculto tres sistemas más adelante.
¿Qué deberían medir los líderes?
Resista la tentación de inventar un panel de control nuevo para cada iniciativa agéntica. Empiece por las métricas de negocio que ya importan: el gasto, los tiempos de entrega, la rotación de inventario, la recuperación, el cumplimiento de los SLA, la experiencia del cliente. Si un sistema agéntico está creando valor real, esos números deberían moverse.
Yo añadiría una sola categoría nueva: la calidad de las decisiones. ¿Con qué frecuencia el sistema tomó la decisión correcta? ¿Con qué frecuencia un humano lo corrigió? ¿Con qué frecuencia reconoció correctamente que no tenía confianza suficiente para actuar?
El sector no necesita docenas de métricas de IA nuevas. Necesita que la IA mejore las métricas de negocio que ya importan a las empresas.
¿Cuál es su definición de comercio agéntico y qué no es?
El comercio agéntico empieza cuando el software puede perseguir un objetivo comercial genuino, ya sea la recuperación máxima, la experiencia del cliente o la capacidad de las instalaciones, a lo largo de una secuencia de decisiones, no solo de una transacción aislada. El valor no está en la palabra “agente”. Está en la capacidad del sistema para navegar entre variables y operar dentro de límites de seguridad para alcanzar realmente ese objetivo.
Lo que no es: un reemplazo total del SaaS. Los sistemas empresariales como SAP llevan años de lógica de negocio y de gobernanza que no van a desaparecer. Ese trabajo ya está hecho, y reconstruirlo no es el punto. Los sistemas agénticos funcionan mejor como complementos: se encargan de tareas especializadas que hacen que el sistema existente sea más rápido y más preciso, en lugar de sustituirlo.
¿Cuándo debería una empresa construir un flujo de trabajo agéntico internamente en lugar de comprarlo a un proveedor?
Este debate es anterior a la IA y no va a desaparecer por ella. ¿Tiene el talento de ingeniería interno? ¿Puede realmente construirlo en el plazo que necesita, sobre todo si quiere ser el primero en llegar al mercado? Un error que veo es suponer que el acceso a un modelo de base potente elimina el trabajo duro de ingeniería. No es así. Los sistemas agénticos en producción siguen exigiendo conocimiento profundo del dominio, integración de sistemas, evaluación, observabilidad, seguridad y gobernanza. El modelo es solo un componente de la arquitectura.
¿Una predicción para los próximos años?
La procedencia de los datos deja de ser un historial reactivo que se consulta cuando algo se rompe y se convierte en una capa estándar y proactiva. Usted sabrá quién cambió un valor y de dónde proviene antes de que cause un problema, no después. Los sistemas avanzan hacia la autorreparación: señalan de forma proactiva que algo va a salir mal y sugieren la corrección antes de que ocurra. Y las decisiones se vuelven más deterministas: reglas, gobernanza y jueces de validación dispuestos alrededor del LLM, con un circuito de retroalimentación hacia el sistema. La calidad y la trazabilidad serán lo que separe los sistemas en los que la gente confía de verdad de los que apenas tolera.
¿Un consejo para los líderes de cadena de suministro?
No intente construir una estrategia de IA para toda su operación de una sola vez. Hágase una pregunta más acotada: ¿qué decisiones concretas está realmente dispuesto a confiar a una máquina? Elija un caso de uso, llévelo a ser completamente agéntico y aprenda de él: supervíselo, demuestre el impacto en el negocio y solo entonces construya la siguiente pieza. Es un enfoque de piezas de Lego: un bloque listo para producción a la vez. Los modelos cambian rápido, pero las decisiones que su negocio realmente necesita tomar no cambian ni de lejos tan rápido.
Lo que me llevo
Tres cosas se me quedaron grabadas.
La deuda operativa es el mejor nombre para el problema. Solemos describirlo como datos que faltan. Nirmal lo describe como decisiones que nadie dejó por escrito, lo cual es más preciso y más incómodo. Significa que el vacío no está en el catálogo. Está en todo lo que se decidió alrededor del catálogo y nunca se registró.
La calidad del contexto es una distinción real, y no es la que hace la mayoría. Unos datos exactos que un agente malinterpreta porque no conoce la restricción que los rodea siguen siendo una decisión equivocada. Volvemos a encontrar el mismo hallazgo desde el otro lado: un campo puede ser correcto y aun así violar la regla que gobierna su categoría.
La procedencia pasa de ser un registro de auditoría a ser una condición previa. Su predicción es que se vuelve proactiva en lugar de reactiva: conocida antes del problema, no reconstruida después. Si eso es cierto, un catálogo que no puede decir de dónde proviene un valor no es simplemente descuidado. Es inutilizable para los sistemas que harán las compras.
Vea lo que su catálogo puede demostrar
Si usted es responsable de datos de producto a gran escala, ofrecemos una evaluación de calidad de datos gratuita. Envíenos una muestra de su catálogo y le devolveremos un informe con lo que encontremos: los identificadores que fallan, las categorías que no coinciden y las inconsistencias que su equipo no puede ver, porque completa los campos tal como la plantilla se lo pedía. Sin ningún compromiso.
Reciba su evaluación de calidad de datos
Mi agradecimiento a Nirmal Jingar por su tiempo y su franqueza. Puede seguir su trabajo en LinkedIn.