Extraire les attributs produit à partir des fiches techniques, des PDF et des fichiers CAO
L’extraction d’attributs semble être un problème résolu, parce que la démonstration utilise toujours le document facile. Un PDF propre, nativement numérique, avec un tableau de spécifications aux libellés clairs, c’est un cas résolu, et depuis des années. Très peu des documents qui déterminent si un produit peut être vendu ressemblent à cela.
Les documents qui comptent, ce sont les manuels d’installation, les dossiers de soumission, les catalogues tarifaires, les plans techniques et les modèles CAO. Ils ont été rédigés pour aider un technicien à installer une pièce ou un tourneur-fraiseur à en usiner une. Aucun de leurs auteurs ne pensait à une fiche produit. Toute l’information est là. Elle est simplement organisée pour un autre lecteur.
Voici comment la difficulté se répartit réellement entre ces types de sources, et pourquoi la moitié la plus difficile du problème commence après l’étape d’extraction, et non pendant.
La difficulté est une échelle, pas un palier
Traiter l’extraction comme une seule et même capacité, c’est la première erreur. Un pipeline qui annonce un chiffre de précision unique sur un ensemble de documents hétérogène fait la moyenne de cinq problèmes différents, et n’en résout probablement pas quatre.
Les PDF nativement numériques, avec une couche texte. Cet échelon est réellement résolu. Les caractères sont déjà là et n’ont pas besoin d’être reconnus. La seule vraie difficulté est l’ordre de lecture : une mise en page sur deux colonnes, avec encadrés et notes de bas de page, n’a pas de séquence intrinsèque, et un outil de lecture naïf les entremêle. Un problème bien compris, auquel personne ne devrait consacrer ses efforts.
Les PDF numérisés ou composés uniquement d’images. Pas de couche texte : les caractères doivent être reconnus, et non lus. La reconnaissance optique de caractères (OCR) est aujourd’hui performante sur une numérisation propre, à une résolution raisonnable. Elle se dégrade dans les conditions qui caractérisent la plupart des archives industrielles : un catalogue tarifaire faxé deux fois en 2011, un tampon qui masque un numéro de modèle, une page numérisée légèrement de travers, un tableau dont les filets se sont estompés au point que les colonnes ne se distinguent plus comme des colonnes.
Les tableaux. Ici, ce ne sont plus les caractères qui posent problème, c’est la structure. Un tableau de spécifications n’est pas du texte. C’est une grille de relations, et c’est la relation qui porte le sens. Une cellule d’en-tête fusionnée sur trois colonnes s’applique aux trois. Une unité déclarée une seule fois dans un en-tête s’applique à toutes les valeurs situées en dessous, et n’apparaît nulle part à proximité. Un appel de note modifie une valeur sous condition. Une ligne se poursuit sur la page suivante sous un en-tête répété, et devient deux fiches si rien ne le détecte. Si la structure est mal lue, le résultat est pire que rien : des valeurs dont chaque caractère est exact, rattachées au mauvais attribut, sans aucun signe que quelque chose a mal tourné.
Les dessins techniques. Deux choses les rendent difficiles, et c’est la seconde qui est intéressante.
La première : dans un dessin, le texte n’est pas disposé comme du texte. Les valeurs de cote suivent des lignes de repère, pivotées selon l’angle qu’exige l’élément annoté, parfois à quatre-vingt-dix degrés, parfois à l’envers par rapport à la page. Les dessins sont souvent doublement cotés, les millimètres en cote principale et les pouces entre crochets, ou l’inverse. Un outil de lecture qui suppose des lignes de texte horizontales ne trouve qu’une fraction de ce qui figure sur la page, et n’a aucun moyen de savoir ce qu’il a manqué.
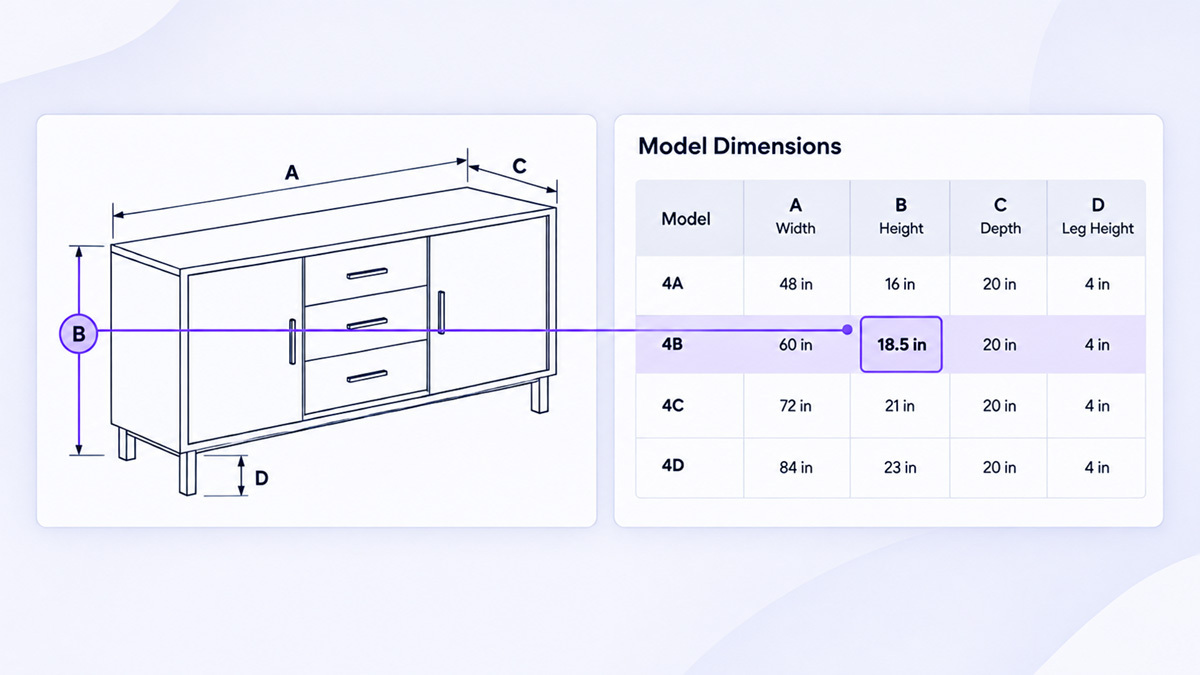
La seconde : les valeurs ne figurent souvent pas du tout dans le dessin. Un même dessin représente couramment toute une famille de produits. Les cotes sont repérées par des lettres, A, B, C, D, qui renvoient à un tableau situé ailleurs dans le document, dont chaque ligne correspond à un numéro de modèle. C’est une convention délibérée, employée précisément pour qu’un seul dessin serve à de nombreuses pièces sans répéter les cotes ni tracer de longues lignes de repère.
Conséquence pour l’extraction : la géométrie et les valeurs se trouvent à deux endroits différents. Le dessin porte la forme et les lettres. Le tableau porte les nombres, sous des en-têtes nommés de A à H. Ni l’un ni l’autre n’est une fiche produit. Un extracteur qui lit le dessin renvoie une figure annotée de lettres. Un extracteur qui lit le tableau renvoie une grille de nombres aux noms de colonnes dénués de sens. Seul un système qui comprend que les deux forment un même document fournit ce que tout le monde cherchait : la hauteur du modèle 4B, en pouces.
C’est une jointure, et la clé de jointure est une convention de dessin, pas une norme. Elle varie selon le fabricant, et parfois d’un document à l’autre chez un même fabricant. C’est aussi la toute première cause d’absence des attributs dimensionnels dans les catalogues industriels, et elle n’est presque jamais décrite comme un échec d’extraction, parce que rien n’a échoué de manière visible. Le pipeline a lu les deux pages et n’a rien tiré d’exploitable ni de l’une ni de l’autre.
Les fichiers CAO. Un fichier CAO n’est pas un document. C’est un modèle, et ce que vous pouvez en tirer dépend largement du type de fichier que l’on vous a envoyé.
La géométrie est la partie fiable. Les dimensions d’encombrement, le volume et les propriétés de masse, lorsque la densité est définie, se déduisent du modèle lui-même au lieu d’être lus sur une page, ce qui les rend plus dignes de confiance que tout ce que l’OCR permet de récupérer.
C’est sur les informations de fabrication que les formats divergent. Cotes, tolérances, cotation et tolérancement géométriques, états de surface et notes peuvent être portés soit sous forme sémantique, soit sous forme d’images de cette sémantique. STEP AP242 a été conçu pour porter des informations produit et de fabrication qu’une machine peut interpréter, avec les tolérances et les éléments de référence rattachés aux entités géométriques qu’ils régissent. Les protocoles antérieurs comme AP203 et AP214, ainsi que les annotations purement graphiques, quel que soit le format, reproduisent l’apparence de l’annotation sans sa signification. Deux fichiers qui semblent identiques à l’ouverture peuvent différer du tout au tout dans ce qu’un pipeline est capable d’en lire. Les formats bidimensionnels comme DWG et DXF relèvent de la géométrie de dessin, des lignes et des entités texte dotées de coordonnées, ce qui vous ramène au problème des dessins techniques, avec de meilleures données d’entrée et la même jointure.
Reste enfin la partie qu’aucune technique d’extraction ne traite. Un modèle CAO décrit une pièce telle qu’elle est fabriquée. Une fiche produit décrit un article tel qu’il est vendu. Les dimensions du produit emballé, le poids d’expédition, la quantité par carton, le contenu réel de la boîte, ou encore quelles finitions sont des variantes commandables plutôt que des options de configuration : rien de tout cela ne figure dans le modèle, parce que le modèle ne sait pas qu’il est un SKU. Les récupérer est un autre exercice, et faire comme si le modèle les contenait produit des fiches fausses, affirmées avec assurance.
Une valeur extraite est une affirmation, pas un fait
Supposons que chaque échelon ci-dessus soit maîtrisé. Il reste une étape que la plupart des pipelines sautent entièrement.
Interrogez trois documents sur le même attribut et vous obtiendrez souvent trois réponses. La fiche technique donne une valeur, le manuel d’installation une autre, le catalogue tarifaire une troisième. En général, aucune n’est une erreur. Les trois étaient exactes au moment de leur rédaction, et une ou deux ont une révision de retard. Le catalogue doit en retenir une, et ce choix est une décision, pas une lecture.
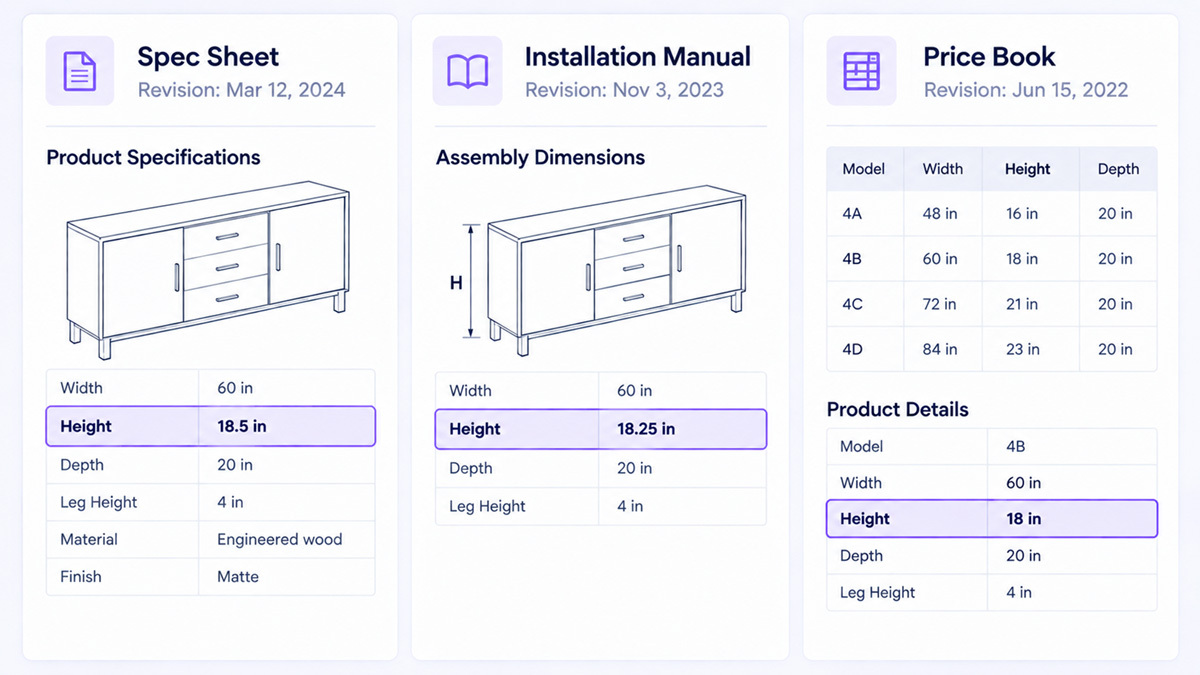
C’est pourquoi la provenance n’est pas une lourdeur administrative. Chaque valeur extraite doit indiquer d’où elle vient : quel document, quelle page, quelle révision, et par quelle méthode elle a été récupérée. Sans cet historique, il n’y a aucun moyen d’arbitrer un conflit, aucun moyen de rejouer une décision lorsqu’un document est remplacé, et aucun moyen de répondre à un client qui conteste un chiffre. Une valeur sans provenance ne peut pas être défendue, et ce qui ne peut pas être défendu n’aurait pas dû être livré.
L’ordre de priorité doit ensuite être une règle explicite, et non un accident de l’ordre de traitement. Quel type de document l’emporte, comment les dates de révision départagent les sources à égalité, et ce qui se passe lorsque la source retenue ne dit rien : ce sont des questions de règles de gestion, qui doivent être inscrites explicitement dans le pipeline. Les systèmes qui laissent tout cela implicite produisent des catalogues dont les valeurs dépendent de l’ordre, fortuit, dans lequel les fichiers sont arrivés, et ce n’est pas un système sur lequel qui que ce soit puisse raisonner.
Les scores de précision ne mesurent pas ce qu’il faut
La recherche sur l’extraction rapporte des scores de précision, généralement sous forme de score F1, et les chiffres sont élevés. Les travaux publiés par Walmart sur son système d’extraction d’attributs font état d’un score F1 moyen de 92,5 % sur les attributs textuels, une performance solide sur un problème difficile, et l’article mérite d’être lu.
Une moyenne n’est pas la bonne mesure pour cette décision, et ce pour trois raisons.
La première est arithmétique. Avec 92 % de précision sur 63 attributs et 50 000 fiches, il reste de l’ordre d’un quart de million de valeurs incorrectes, réparties de façon invisible dans le catalogue. Personne n’inspecte un quart de million de valeurs à la main : en pratique, le taux d’erreur n’est donc pas une quantité connue que l’on peut gérer. C’est le rythme auquel les surprises arriveront plus tard.
La deuxième : les erreurs ne sont pas interchangeables. Une spécification manquante fait perdre une vente, ce qui est fâcheux, mais rattrapable. Une dimension erronée est commandée, expédiée, installée puis retournée, et elle emporte la relation client avec elle. Fondre ces deux issues dans un seul chiffre détruit la seule distinction qui compte sur le plan opérationnel.
La troisième tient au mode de défaillance propre à l’extraction générative. Lorsqu’un modèle qui lit une cote maculée se trompe, il ne renvoie pas un champ vide. Il renvoie un nombre plausible, dans une plage raisonnable, dans la bonne unité, mis en forme exactement comme les valeurs qui l’entourent. Il passe toutes les vérifications qu’un relecteur effectue à l’œil, parce qu’il a été produit pour ressembler précisément à une bonne réponse. Un champ vide se signale de lui-même. Une valeur fausse affirmée avec assurance, non, et c’est de loin la plus coûteuse des deux.
L’indicateur qui reflète vraiment le risque n’est pas la précision moyenne. C’est la part des valeurs livrées qui ont été vérifiées selon les règles de leur catégorie, et la part qui a été livrée parce que rien ne s’y opposait. Ce sont deux chiffres très différents, et un seul d’entre eux est habituellement communiqué. Il existe de meilleures dimensions pour mesurer les données produit, et un score de précision d’extraction n’en fait pas partie.
Ce qui doit se passer après la lecture
L’extraction est la première étape du pipeline, et la traiter comme le pipeline tout entier est l’erreur structurelle qui sous-tend la plupart de ces échecs. Tirer un chiffre d’une page est une capacité. Savoir si ce chiffre a le droit de prendre cette valeur dans cette catégorie en est une autre, et c’est elle qui décide si une fiche peut être livrée.
C’est autour de cette couche qu’atronous est construit. L’IA prend en charge le travail génératif : lire des documents qui n’ont jamais été structurés pour un catalogue. La logique déterministe valide chaque valeur renvoyée selon une couche de contraintes couvrant plus de 400 catégories de produits, chacune avec son propre vocabulaire, ses conventions d’unités, ses axes de variation autorisés et ses règles d’identifiants, appliqués indépendamment. Une règle correcte pour les centrales de traitement d’air devient un défaut dès qu’elle s’applique à la visserie, et c’est pourquoi les deux ne partagent jamais le même référentiel de règles. La génération et la validation sont, par conception, des systèmes distincts, et ne sont jamais confondues.
Les identifiants passent plusieurs contrôles avant livraison : format, clé de contrôle, croisement avec les registres, unicité au sein de la livraison et correspondance avec la référence fabricant. Chaque valeur porte aussi sa provenance, de sorte qu’un chiffre contesté peut être rattaché à la source qui l’a fourni. Une livraison type pour un grand compte fait ressortir 18 catégories distinctes d’anomalies de qualité des données, chacune signalée avec sa justification au lieu d’être écartée en silence. Une livraison de 50 000 fiches atteint un taux de succès de 98 % ou plus, avec un taux de validation des identifiants produit de 100 % et aucun doublon d’identifiant. Chaque changement de règle est consigné par date, source et justification, de sorte qu’une valeur livrée le trimestre dernier peut encore être expliquée ce trimestre-ci.
Le principe qui sous-tend tout cela : un sous-ensemble validé, avec des exceptions documentées, vaut mieux qu’un fichier complet aux erreurs cachées. Dix mille fiches vérifiées et un reliquat signalé, c’est un bon résultat. Treize mille fiches avec un taux d’erreur inconnu, c’est un problème qui apparaît après la mise en ligne, soit au pire moment possible pour le découvrir.
Sur ces types de documents en particulier, les travaux sur l’extraction de schémas techniques expliquent comment les diagrammes sont isolés et étiquetés au sein de documents techniques encombrés. Tout ce qui est récupéré dans ces sources est classé dans la bonne catégorie avant que les fiches vérifiées soient livrées à un PIM ou à un ERP, où les propres systèmes du client prennent le relais.
Il y a aujourd’hui une raison de s’en préoccuper qui ne s’appliquait pas il y a cinq ans. Les fiches produit sont de plus en plus lues par des agents IA plutôt que par des personnes, et un agent qui compare deux produits ne regarde ni les photos ni le texte marketing. Il compare des attributs, et il n’a aucun moyen de distinguer une dimension vérifiée d’une dimension plausible. Les catalogues construits pour que chaque valeur puisse être rattachée à une source et vérifiée selon une règle sont ceux sur lesquels ces systèmes pourront s’appuyer. C’est vers cela que se dirige le commerce, et cela augmente considérablement le coût d’un chiffre faux affirmé avec assurance.
Faites mesurer vos propres données
Le moyen le plus rapide de savoir quelle part de vos informations produit est récupérable est d’en faire traiter un échantillon. C’est ce que fait l’évaluation de la qualité des données d’atronous. Envoyez jusqu’à 50 SKU extraits de votre PIM ou de votre ERP, exactement tels qu’ils vivent dans votre système, et nous les faisons passer par le même pipeline que celui sur lequel s’appuient nos clients grands comptes. Sous cinq jours ouvrés, vous recevez votre échantillon généré et validé, avec les recommandations de taxonomie et de schéma qui expliquent le travail, et une session de travail pour passer en revue ce que nous avons trouvé.
Sans argumentaire commercial. Vos propres fiches, mesurées selon les règles de leurs catégories.
Demandez votre évaluation de la qualité des données, ou découvrez comment atronous traite les données produit techniques et industrielles.
L’intelligence dans chaque attribut.
Questions fréquentes
Qu’est-ce que l’extraction d’attributs produit ?
L’extraction d’attributs produit consiste à récupérer des valeurs d’attributs structurées, comme les dimensions, la capacité, le matériau, la tension ou la certification, dans des documents qui n’ont pas été conçus pour être lus par une machine. Les sources comprennent les fiches techniques, les manuels d’installation, les dossiers de soumission, les catalogues tarifaires, les plans techniques et les modèles CAO. L’étape d’extraction renvoie des valeurs candidates. Ces valeurs doivent encore être normalisées dans une unité et un vocabulaire cohérents, vérifiées selon les règles de la catégorie de produits et réconciliées lorsque les documents divergent, avant de pouvoir être livrées sous forme de fiche produit.
Peut-on extraire des attributs produit de fichiers CAO ?
Oui, avec une réserve importante : ce qui est récupérable dépend du format. La géométrie, y compris les dimensions d’encombrement et les propriétés de masse lorsque la densité est définie, se déduit directement du modèle. Les tolérances, la cotation et le tolérancement géométriques, ainsi que les annotations, ne sont lisibles par une machine que si le fichier les porte sous forme sémantique, ce pour quoi STEP AP242 a été conçu. Les protocoles plus anciens et les annotations purement graphiques reproduisent l’apparence de ces informations sans leur signification. Par ailleurs, aucun fichier CAO ne contient d’attributs commerciaux comme les dimensions du produit emballé, la quantité par carton ou les variantes commandables, car le modèle décrit une pièce telle qu’elle est fabriquée, et non un produit tel qu’il est vendu.
Pourquoi l’extraction est-elle plus difficile sur les dessins techniques que sur les PDF ?
Pour deux raisons. Dans un dessin, le texte des cotes est pivoté et placé pour annoter des éléments, au lieu d’être disposé en lignes : un outil de lecture qui s’attend à du texte horizontal en manque une grande partie. Plus important encore, un même dessin représente généralement toute une famille de produits, avec des cotes indiquées par des lettres qui renvoient à un tableau séparé dont chaque ligne correspond à un numéro de modèle. Le dessin porte la géométrie et les lettres, le tableau porte les valeurs, et une fiche exploitable n’existe que lorsque les deux sont joints. Les pipelines qui lisent chaque page indépendamment n’en tirent rien d’exploitable, ni de l’une ni de l’autre.
Quel niveau de précision l’extraction d’attributs produit doit-elle atteindre ?
La précision moyenne n’est pas la bonne question, car les erreurs ne se valent pas. Une valeur manquante fait perdre une vente, alors qu’une dimension erronée est commandée, expédiée, puis retournée. L’extraction générative échoue en renvoyant des valeurs plausibles plutôt que des champs vides : les erreurs ne se signalent donc pas d’elles-mêmes. L’indicateur qui mérite d’être suivi est la part des valeurs livrées qui ont été vérifiées selon les règles de la catégorie, et la part qui a été livrée parce que rien ne s’y opposait. Un sous-ensemble validé, avec des exceptions documentées, est un meilleur résultat qu’un fichier complet au taux d’erreur inconnu.