Extraer atributos de producto a partir de fichas técnicas, PDF y archivos CAD
La extracción de atributos parece un problema resuelto porque la demostración siempre usa el documento fácil. Un PDF limpio, nativo digital, con una tabla de especificaciones etiquetada es un caso resuelto, y lo es desde hace años. Muy pocos de los documentos que deciden si un producto se puede vender se parecen a eso.
Los documentos que importan son manuales de instalación, documentación técnica de aprobación (submittals), listas de precios, planos de ingeniería y modelos CAD. Se redactaron para ayudar a un técnico a instalar una pieza o a un operario de mecanizado a cortarla. Ninguna de las personas que los elaboraron pensaba en un registro de producto. Toda la información está ahí. Simplemente está organizada para otro lector.
Lo que sigue explica cómo se reparte realmente la dificultad entre esos tipos de fuente, y por qué la mitad más difícil del problema empieza después del paso de extracción y no durante él.
La dificultad es una escalera, no un único nivel
Tratar la extracción como una sola capacidad es el primer error. Un pipeline que da una única cifra de exactitud para un conjunto mixto de documentos está promediando cinco problemas distintos, y probablemente no está resolviendo cuatro de ellos.
PDF nativos digitales con capa de texto. Este peldaño está realmente resuelto. Los caracteres ya están ahí y no hace falta reconocerlos. La única dificultad real es el orden de lectura, porque una maquetación a dos columnas con recuadros laterales y notas al pie no tiene una secuencia inherente, y un lector ingenuo los intercala. Es un problema bien comprendido, y no es donde nadie debería dedicar esfuerzo.
PDF escaneados y PDF que solo contienen imágenes. No hay capa de texto, así que los caracteres hay que reconocerlos en lugar de leerlos. El reconocimiento óptico de caracteres (OCR) es hoy sólido en un escaneo limpio con una resolución razonable. Se degrada en las condiciones que describen la mayoría de los archivos documentales industriales: una lista de precios enviada por fax dos veces en 2011, un sello que tapa un número de modelo, una página escaneada ligeramente torcida, una tabla cuyas líneas se fueron borrando hasta que las columnas dejaron de distinguirse como columnas.
Tablas. Aquí los caracteres dejan de ser el problema y el problema pasa a ser la estructura. Una tabla de especificaciones no es texto. Es una cuadrícula de relaciones, y es la relación la que transmite el significado. Una celda de encabezado combinada sobre tres columnas se aplica a las tres. Una unidad declarada una sola vez en un encabezado se aplica a todos los valores que tiene debajo y no aparece cerca de ninguno de ellos. Una llamada de nota al pie modifica un valor de forma condicional. Una fila continúa en la página siguiente bajo un encabezado repetido y se convierte en dos registros, a menos que algo lo detecte. Si se lee mal la estructura, el resultado es peor que nada: valores con una exactitud de caracteres perfecta, asociados al atributo equivocado, sin ninguna señal de que algo haya salido mal.
Dibujos técnicos. Dos cosas los hacen difíciles, y la segunda es la interesante.
La primera es que el texto de un dibujo no está dispuesto como un texto. Los valores de las cotas se sitúan a lo largo de líneas de referencia, girados al ángulo que requiera la anotación del elemento, a veces a noventa grados, a veces invertidos respecto de la página. Los dibujos suelen tener doble acotación, con los milímetros como unidad principal y las pulgadas entre corchetes, o al revés. Un lector que presupone líneas horizontales de texto encuentra una fracción de lo que hay en la página y no tiene forma de saber qué se le escapó.
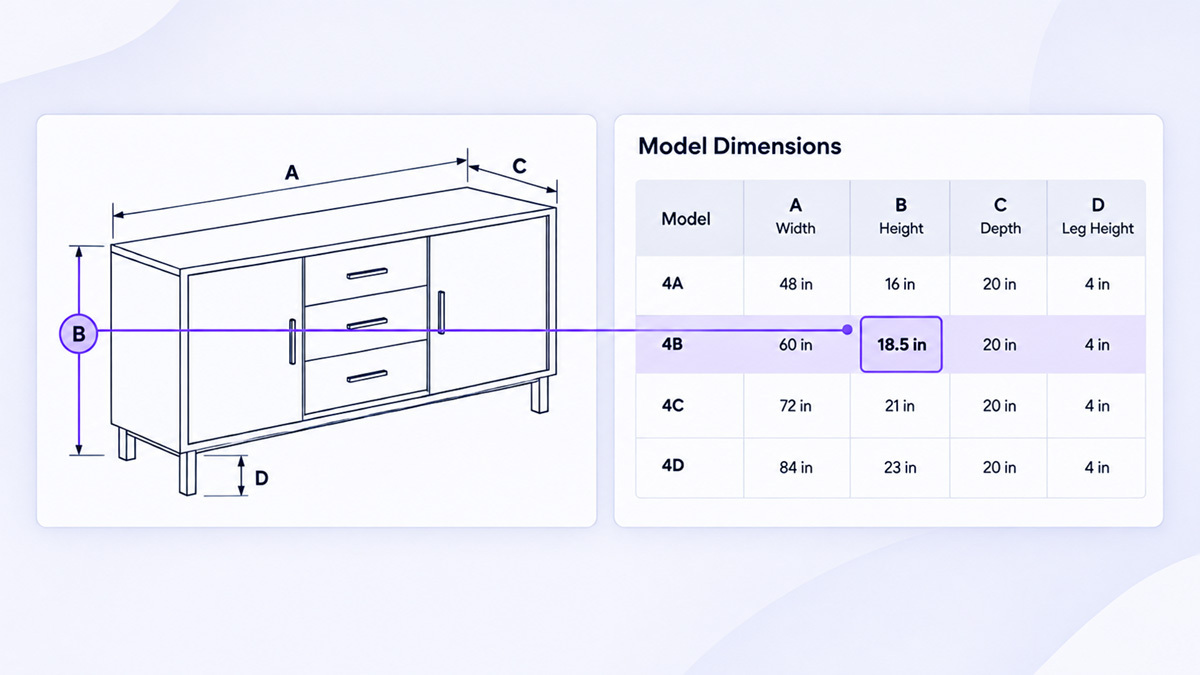
La segunda es que a menudo los valores ni siquiera están en el dibujo. Es habitual que un solo dibujo represente toda una familia de productos. Las cotas se indican con letras, A, B, C, D, que remiten a una tabla situada en otra parte del documento, donde cada fila es un número de modelo. Es una convención deliberada, que se usa precisamente para que un mismo dibujo sirva para muchas piezas sin repetir cotas ni trazar largas líneas de referencia.
La consecuencia para la extracción es que la geometría y los valores están en dos lugares. El dibujo contiene la forma y las letras. La tabla contiene los números bajo encabezados que van de la A a la H. Ninguno de los dos es un registro de producto. Un extractor que lee el dibujo devuelve un diagrama anotado con letras. Un extractor que lee la tabla devuelve una cuadrícula de números con nombres de columna que no significan nada. Solo un sistema que entiende que ambos son el mismo documento produce lo que de verdad se buscaba, que es la altura del modelo 4B en pulgadas.
Eso es un cruce de datos (un join), y la clave del cruce es una convención de dibujo técnico, no un estándar. Varía según el fabricante y, a veces, según el documento dentro de un mismo fabricante. También es la razón más frecuente por la que faltan atributos dimensionales en los catálogos industriales, y casi nunca se describe como un fallo de extracción, porque nada falló de forma evidente. El pipeline leyó las dos páginas y no obtuvo nada utilizable de ninguna de ellas.
Archivos CAD. Un archivo CAD no es un documento. Es un modelo, y lo que se puede extraer de él depende en gran medida del tipo que le hayan enviado.
La geometría es la parte fiable. Las dimensiones envolventes, el volumen y las propiedades de masa (cuando la densidad está definida) se pueden derivar del propio modelo en lugar de leerse en una página, lo que los hace más dignos de confianza que cualquier dato recuperado mediante OCR.
La información de fabricación es donde los formatos divergen. Las cotas, las tolerancias, el dimensionamiento y tolerancias geométricas, el acabado superficial y las notas pueden transmitirse como semántica o como imágenes de la semántica. STEP AP242 se diseñó para contener información de producto y de fabricación que una máquina puede interpretar, con las tolerancias y los elementos de referencia vinculados a las entidades geométricas que rigen. Los protocolos anteriores, como AP203 y AP214, y las anotaciones solo gráficas en cualquier formato contienen la apariencia de la anotación sin su significado. Dos archivos que parecen idénticos al abrirlos pueden diferir por completo en cuánto puede leer de ellos un pipeline. Los formatos bidimensionales como DWG y DXF son geometría de dibujo (líneas y entidades de texto con coordenadas), lo que supone volver al problema de los dibujos técnicos con mejores datos de entrada y el mismo cruce.
Luego está la parte que ninguna técnica de extracción aborda. Un modelo CAD describe una pieza tal como se fabrica. Un registro de producto describe algo tal como se vende. Las dimensiones con embalaje, el peso de envío, la cantidad por caja, el contenido real del paquete y qué acabados son variantes que se pueden pedir y no opciones de configuración no están en el modelo, porque el modelo no sabe que es un SKU. Recuperar esos datos es un ejercicio distinto, y fingir que el modelo los contiene produce registros tan seguros como erróneos.
Un valor extraído es una afirmación, no un hecho
Supongamos que cada uno de los peldaños anteriores está resuelto. Aún queda un paso que la mayoría de los pipelines omite por completo.
Pida el mismo atributo a tres documentos y con frecuencia obtendrá tres respuestas. La ficha técnica da un valor, el manual de instalación da otro y la lista de precios da un tercero. Por lo general, ninguno de ellos es un error. Los tres eran correctos cuando se redactaron, y uno o dos van una revisión por detrás. El catálogo tiene que quedarse con uno, y quedarse con uno es una decisión, no una lectura.
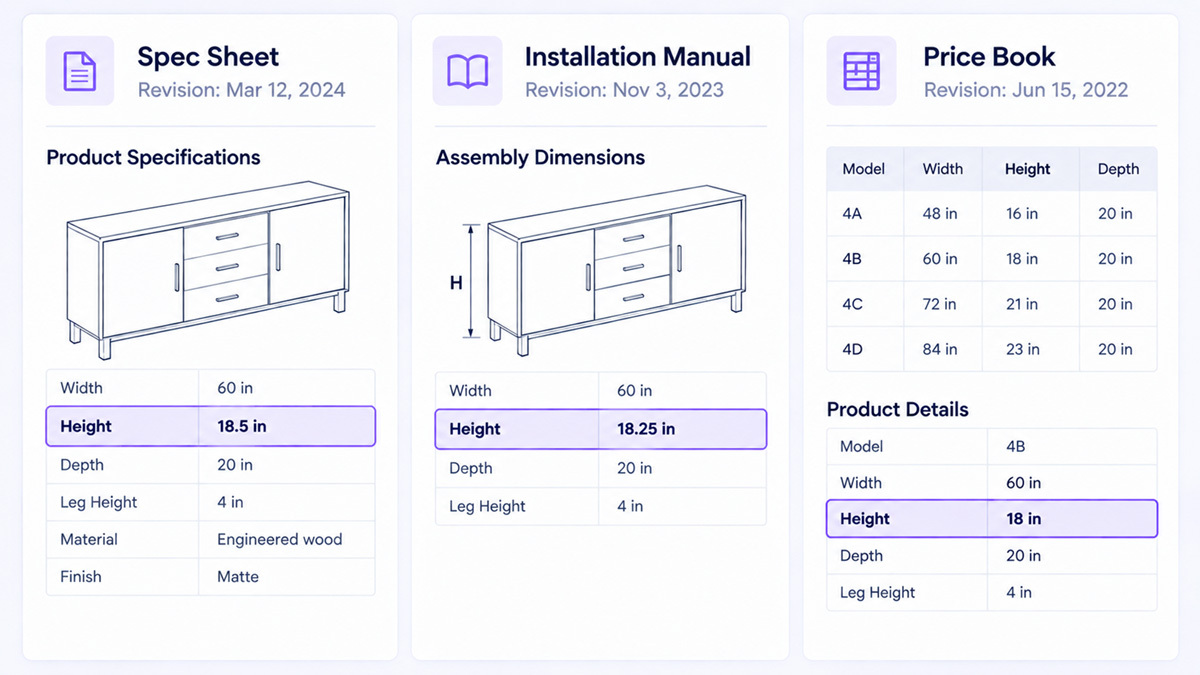
Por eso la procedencia no es una carga administrativa. Cada valor extraído debe llevar consigo de dónde procede: qué documento, qué página, qué revisión y con qué método se recuperó. Sin ese registro no hay forma de dirimir un conflicto, no hay forma de rehacer una decisión cuando un documento queda sustituido y no hay forma de responder a un cliente que discute una cifra. Un valor sin procedencia no se puede defender, y nada que no se pueda defender debería haberse entregado.
A partir de ahí, el orden de prelación tiene que ser una regla explícita y no un accidente del orden de procesamiento. Qué clase de documento prevalece, cómo desempatan las fechas de revisión y qué ocurre cuando la fuente que prevalece no dice nada son cuestiones de política que deben figurar explícitamente en el pipeline. Los sistemas que dejan esto implícito producen catálogos cuyos valores dependen del orden en que los archivos llegaron por casualidad, y eso no es un sistema sobre el que nadie pueda razonar.
Las puntuaciones de exactitud miden lo que no corresponde
La investigación sobre extracción expresa la exactitud, normalmente como puntuación F1, y las cifras son altas. El trabajo publicado por Walmart sobre su marco de extracción de atributos informa de una F1 media del 92,5 % en los atributos de texto, un rendimiento sólido en un problema difícil, y vale la pena leer el artículo.
Un promedio no es la medida adecuada para esta decisión, por tres razones.
La primera es aritmética. Un 92 % aplicado a 63 atributos en 50.000 registros deja del orden de un cuarto de millón de valores incorrectos, repartidos de forma invisible por el catálogo. Nadie inspecciona a mano un cuarto de millón de valores, así que, en la práctica, la tasa de error no es una cantidad conocida que se pueda gestionar. Es la frecuencia con la que llegarán sorpresas más adelante.
La segunda es que los errores no son intercambiables. Una especificación que falta hace perder una venta, lo cual es malo y recuperable. Una dimensión errónea se pide, se envía, se instala y se devuelve, y se lleva consigo la relación con el cliente. Promediar esos dos resultados en una sola cifra destruye la única distinción que importa desde el punto de vista operativo.
La tercera es el modo de fallo propio de la extracción generativa. Cuando un modelo que lee una cota emborronada se equivoca, no devuelve un campo vacío. Devuelve un número plausible, en un rango razonable, en la unidad correcta, con exactamente el mismo formato que los valores que lo rodean. Supera todas las comprobaciones que un revisor hace a simple vista, porque se generó para parecerse exactamente a una respuesta correcta. Un campo vacío salta a la vista. Un valor erróneo presentado con total seguridad, no, y es con mucha diferencia el más costoso de los dos.
La medida que de verdad refleja el riesgo no es la exactitud media. Es qué proporción de los valores entregados se verificó según las reglas de la categoría a la que pertenecen y qué proporción se entregó porque nada lo cuestionó. Son cifras muy distintas, y normalmente solo se comunica una de ellas. Hay mejores dimensiones para medir los datos de producto, y una puntuación de exactitud de extracción no está entre ellas.
Lo que tiene que ocurrir después de la lectura
La extracción es la primera etapa del pipeline, y tratarla como si fuera todo el pipeline es el error estructural que subyace a la mayoría de estos fallos. Sacar un número de una página es una capacidad. Saber si ese número puede tener ese valor en esa categoría es otra capacidad distinta, y es la que decide si un registro se puede entregar.
Esa es la capa en torno a la cual se ha construido atronous. La IA se encarga del trabajo generativo de leer documentos que nunca se estructuraron pensando en un catálogo. La lógica determinista valida cada valor obtenido con respecto a una capa de restricciones que abarca más de 400 categorías de producto, cada una con su propio vocabulario, sus convenciones de unidades, sus dimensiones de variante permitidas y sus reglas de identificadores, que se aplican de forma independiente. Una regla correcta para las unidades de tratamiento de aire se convierte en un defecto cuando se aplica a los elementos de fijación, y por eso nunca se permite que ambas categorías compartan el mismo conjunto de reglas. La generación y la validación son sistemas separados por diseño y nunca se mezclan.
Los identificadores pasan por varios controles antes de la entrega: formato, dígito verificador, verificación cruzada con registros, unicidad dentro de la entrega y correlación con la referencia de fabricante. Además, cada valor lleva su procedencia, de modo que una cifra cuestionada se puede rastrear hasta la fuente que la aportó. Una entrega empresarial típica devuelve 18 categorías distintas de problemas de calidad de datos, cada una señalada con su justificación en lugar de descartarse en silencio. Una entrega de 50.000 registros alcanza una tasa de éxito del 98 % o superior, con una tasa de validación de identificadores del 100 % y cero identificadores duplicados. Cada cambio de regla queda registrado con su fecha, su fuente y su justificación, de modo que un valor entregado el trimestre pasado todavía se puede explicar este trimestre.
El principio que subyace a todo ello es que un subconjunto validado con excepciones documentadas vale más que un archivo completo con errores ocultos. Diez mil registros verificados y un resto señalado son un buen resultado. Trece mil registros con una tasa de error desconocida son un problema que aparece después de la puesta en línea, que es el peor momento posible para descubrirlo.
En cuanto a los tipos de documento concretos, el trabajo de extracción de esquemas técnicos explica cómo se aíslan y etiquetan los diagramas dentro de documentos técnicos recargados. Todo lo que se recupera de esas fuentes se clasifica en la categoría correcta antes de que los registros verificados se entreguen a un PIM o un ERP, donde toman el relevo los sistemas del propio cliente.
Hay una razón para prestar atención a esto hoy que no existía hace cinco años. Los registros de producto los leen cada vez más agentes de IA en lugar de personas, y un agente que compara dos productos no mira las fotografías ni los textos. Compara atributos, y no tiene forma de distinguir una dimensión verificada de una plausible. Los catálogos construidos de modo que cada valor se pueda rastrear hasta una fuente y comprobar con una regla son aquellos en los que esos sistemas podrán confiar. Hacia ahí se dirige el comercio, y eso eleva considerablemente el costo de una cifra errónea presentada con total seguridad.
Vea sus propios datos medidos
La forma más rápida de saber qué parte de su información de producto se puede recuperar es ver cómo se procesa una muestra. Eso es lo que hace la Evaluación de Calidad de Datos de atronous. Envíe hasta 50 SKU desde su PIM o su ERP, tal como están en su sistema, y los pasamos por el mismo proceso en el que confían nuestros clientes empresariales. En un plazo de cinco días hábiles recibe la muestra generada y validada, junto con las recomendaciones de taxonomía y esquema que respaldan el trabajo y una sesión de trabajo para revisar lo que encontramos.
Sin discurso comercial. Sus propios registros, medidos según las reglas de sus categorías.
Solicite su Evaluación de Calidad de Datos, o vea cómo trata atronous los datos de producto técnicos e industriales.
Inteligencia en cada atributo.
Preguntas frecuentes
¿Qué es la extracción de atributos de producto?
La extracción de atributos de producto es el proceso de recuperar valores de atributos estructurados, como dimensiones, capacidad, material, voltaje o certificación, a partir de documentos que no se crearon para que los leyera una máquina. Entre las fuentes figuran fichas técnicas, manuales de instalación, documentación técnica de aprobación (submittals), listas de precios, planos de ingeniería y modelos CAD. El paso de extracción devuelve valores candidatos. Esos valores todavía deben normalizarse a una unidad y un vocabulario coherentes, comprobarse según las reglas de la categoría de producto y conciliarse cuando los documentos no coinciden, antes de poder entregarse como un registro de producto.
¿Se pueden extraer atributos de producto de los archivos CAD?
Sí, con una salvedad importante: lo que se puede recuperar depende del formato. La geometría, incluidas las dimensiones envolventes y las propiedades de masa cuando la densidad está definida, se puede derivar directamente del modelo. Las tolerancias, el dimensionamiento y tolerancias geométricas, y las anotaciones solo son legibles por máquina cuando el archivo las contiene de forma semántica, que es para lo que se diseñó STEP AP242. Los protocolos anteriores y las anotaciones solo gráficas contienen la apariencia de esa información sin su significado. Por otra parte, ningún archivo CAD contiene atributos comerciales como las dimensiones con embalaje, la cantidad por caja o las variantes que se pueden pedir, porque el modelo describe una pieza tal como se fabrica y no un producto tal como se vende.
¿Por qué es más difícil extraer datos de los dibujos técnicos que de los PDF?
Por dos razones. El texto de las cotas en un dibujo está girado y colocado para anotar elementos, no dispuesto en líneas, así que un lector que espera texto horizontal pasa por alto buena parte de él. Más importante aún, un dibujo suele representar toda una familia de productos, con las cotas indicadas mediante letras que remiten a una tabla aparte en la que cada fila es un número de modelo. El dibujo contiene la geometría y las letras, la tabla contiene los valores, y un registro utilizable solo existe cuando se cruzan los dos. Los pipelines que leen cada página por separado no obtienen nada utilizable de ninguno de ellos.
¿Qué nivel de exactitud necesita la extracción de atributos de producto?
La exactitud media es la pregunta equivocada, porque los errores no son equivalentes. Un valor que falta hace perder una venta, mientras que una dimensión errónea se pide, se envía y se devuelve. La extracción generativa falla devolviendo valores plausibles en lugar de campos vacíos, así que los errores no se delatan. La medida que vale la pena seguir es qué proporción de los valores entregados se verificó según las reglas de la categoría y qué proporción se entregó porque nada lo cuestionó. Un subconjunto validado con excepciones documentadas es un mejor resultado que un archivo completo con una tasa de error desconocida.